Los LLMs se entrenan para generar una respuesta en base a un prompt. Usan relaciones semánticas para entender las relaciones entre palabras (en lenguaje natural) y generar una respuesta relevante.
Teniendo el siguiente ejemplo, saben identificar las palabras más importantes y la posición contextual en la frase.
I heard a dog bark loudly at a cat
Tokenization
El primer paso es partir el input en tokens
- I (1)
- heard (2)
- a (3)
- dog (4)
- bark (5)
- loudly (6)
- at (7)
- a (3) already assigned
- cat (8)
Vectores iniciales y encoding posicional
Inicialmente los vectores de los tokens se asignan de manera aleatorio, antes de ser alimentados al transformer para crear embeddings. Aparte de estos vectores aleatorios también se envía la posición del token en la secuencia, ya que es determinante para indicar su importancia.
recordar que los vectores aquí son aleatorios antes de que los procese el transformer
| Token | Token ID | Position | Vector |
|---|---|---|---|
| I | 1 | 1 | [3,7,10] |
| heard | 2 | 2 | [2,15,1] |
| a | 3 | 3 | [9,11,1] |
| dog | 4 | 4 | [2,7,11] |
| bark | 5 | 5 | [9,12,0] |
| loudly | 6 | 6 | [3,8,13] |
| at | 7 | 7 | [5,7,10] |
| a | 3 | 8 | [9,11,1] |
| cat | 8 | 9 | [8-6,9] |
Transforming tokens with a transformer
Ahora que tenemos los tokens con un ID, necesitamos relacionarlos entre ellos. Esto se hace asignándoles vectores los cuales contienen el valor semántico del token (llamados embeddings)
[0.12, -0,85, …, 0.42]
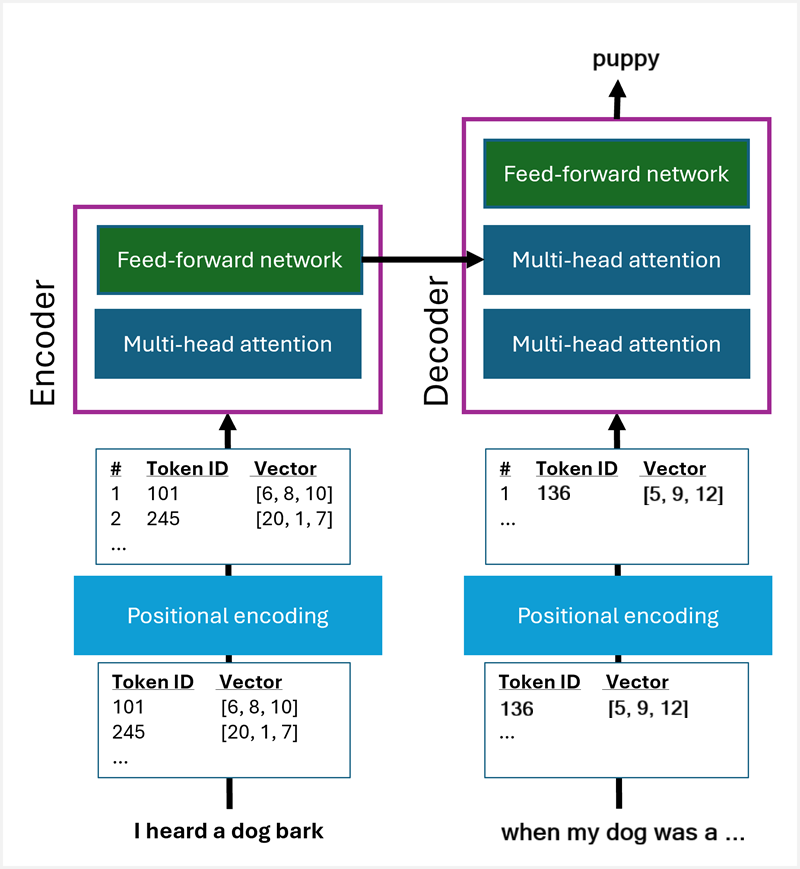
Esto se hace mediante un transformer model, el cual consiste de 2 bloques:
- encoder block: crea los embeddings aplicando una técnica de attention. La attention layer examina cada token por turnos y determina cuánto se ve influenciado ese token por los que están a su alrededor. Para hacer este proceso de manera más eficiente se usa una multi-head attention para examinar tokens de manera paralela y asignarles weights que se usan para calcular los vectores. Los resultados de la attention layer se procesar por una red neuronal para encontrar los vectores que mejor representan al embedding.
- decoder layer: usa los embeddings calculados por el encoder para determinar el próximo token más probable en una secuencia comenzada por un prompt. El decoder también consiste de una attention layer y una red neuronal para hacer sus predicciones
Attention y embeddings
Para determinar los vectores que representan los tokens, y que incluyen la información embebida en ellos, el transformer usa las attention layers. Esta attention layer considera cada token junto a su contexto dentro de la secuencia en la que aparece. Este contexto de tokens se valora para determinar la influencia del token que estamos midiendo y se usan los weight para calcular los embedding vectors del token.
Para entenderlo, siguiendo nuestro ejemplo de la frase I heard a dog bark, a los tokens “heard” y “dog” se les asignará más valor que a los tokens de “I” o “a”
El resultado del proceso de encoding es un set de embeddings; vectores que incluyen la información semántica de los tokens y de cómo estos se relacionan entre ellos.
| Token | Token ID | Vector |
|---|---|---|
| I | 1 | [2,0,-1] |
| heard | 2 | [-2,2,4] |
| a | 3 | [-3,5,5] |
| dog | 4 | [10,3,2] |
| bark | 5 | [9,2,10] |
| loudly | 6 | [-3,8,3] |
| at | 7 | [-5,-1,1] |
| cat | 8 | [10,3,1] |
Podemos pensar en los embeddings como valores multi-dimensionales en un espacio vectorial
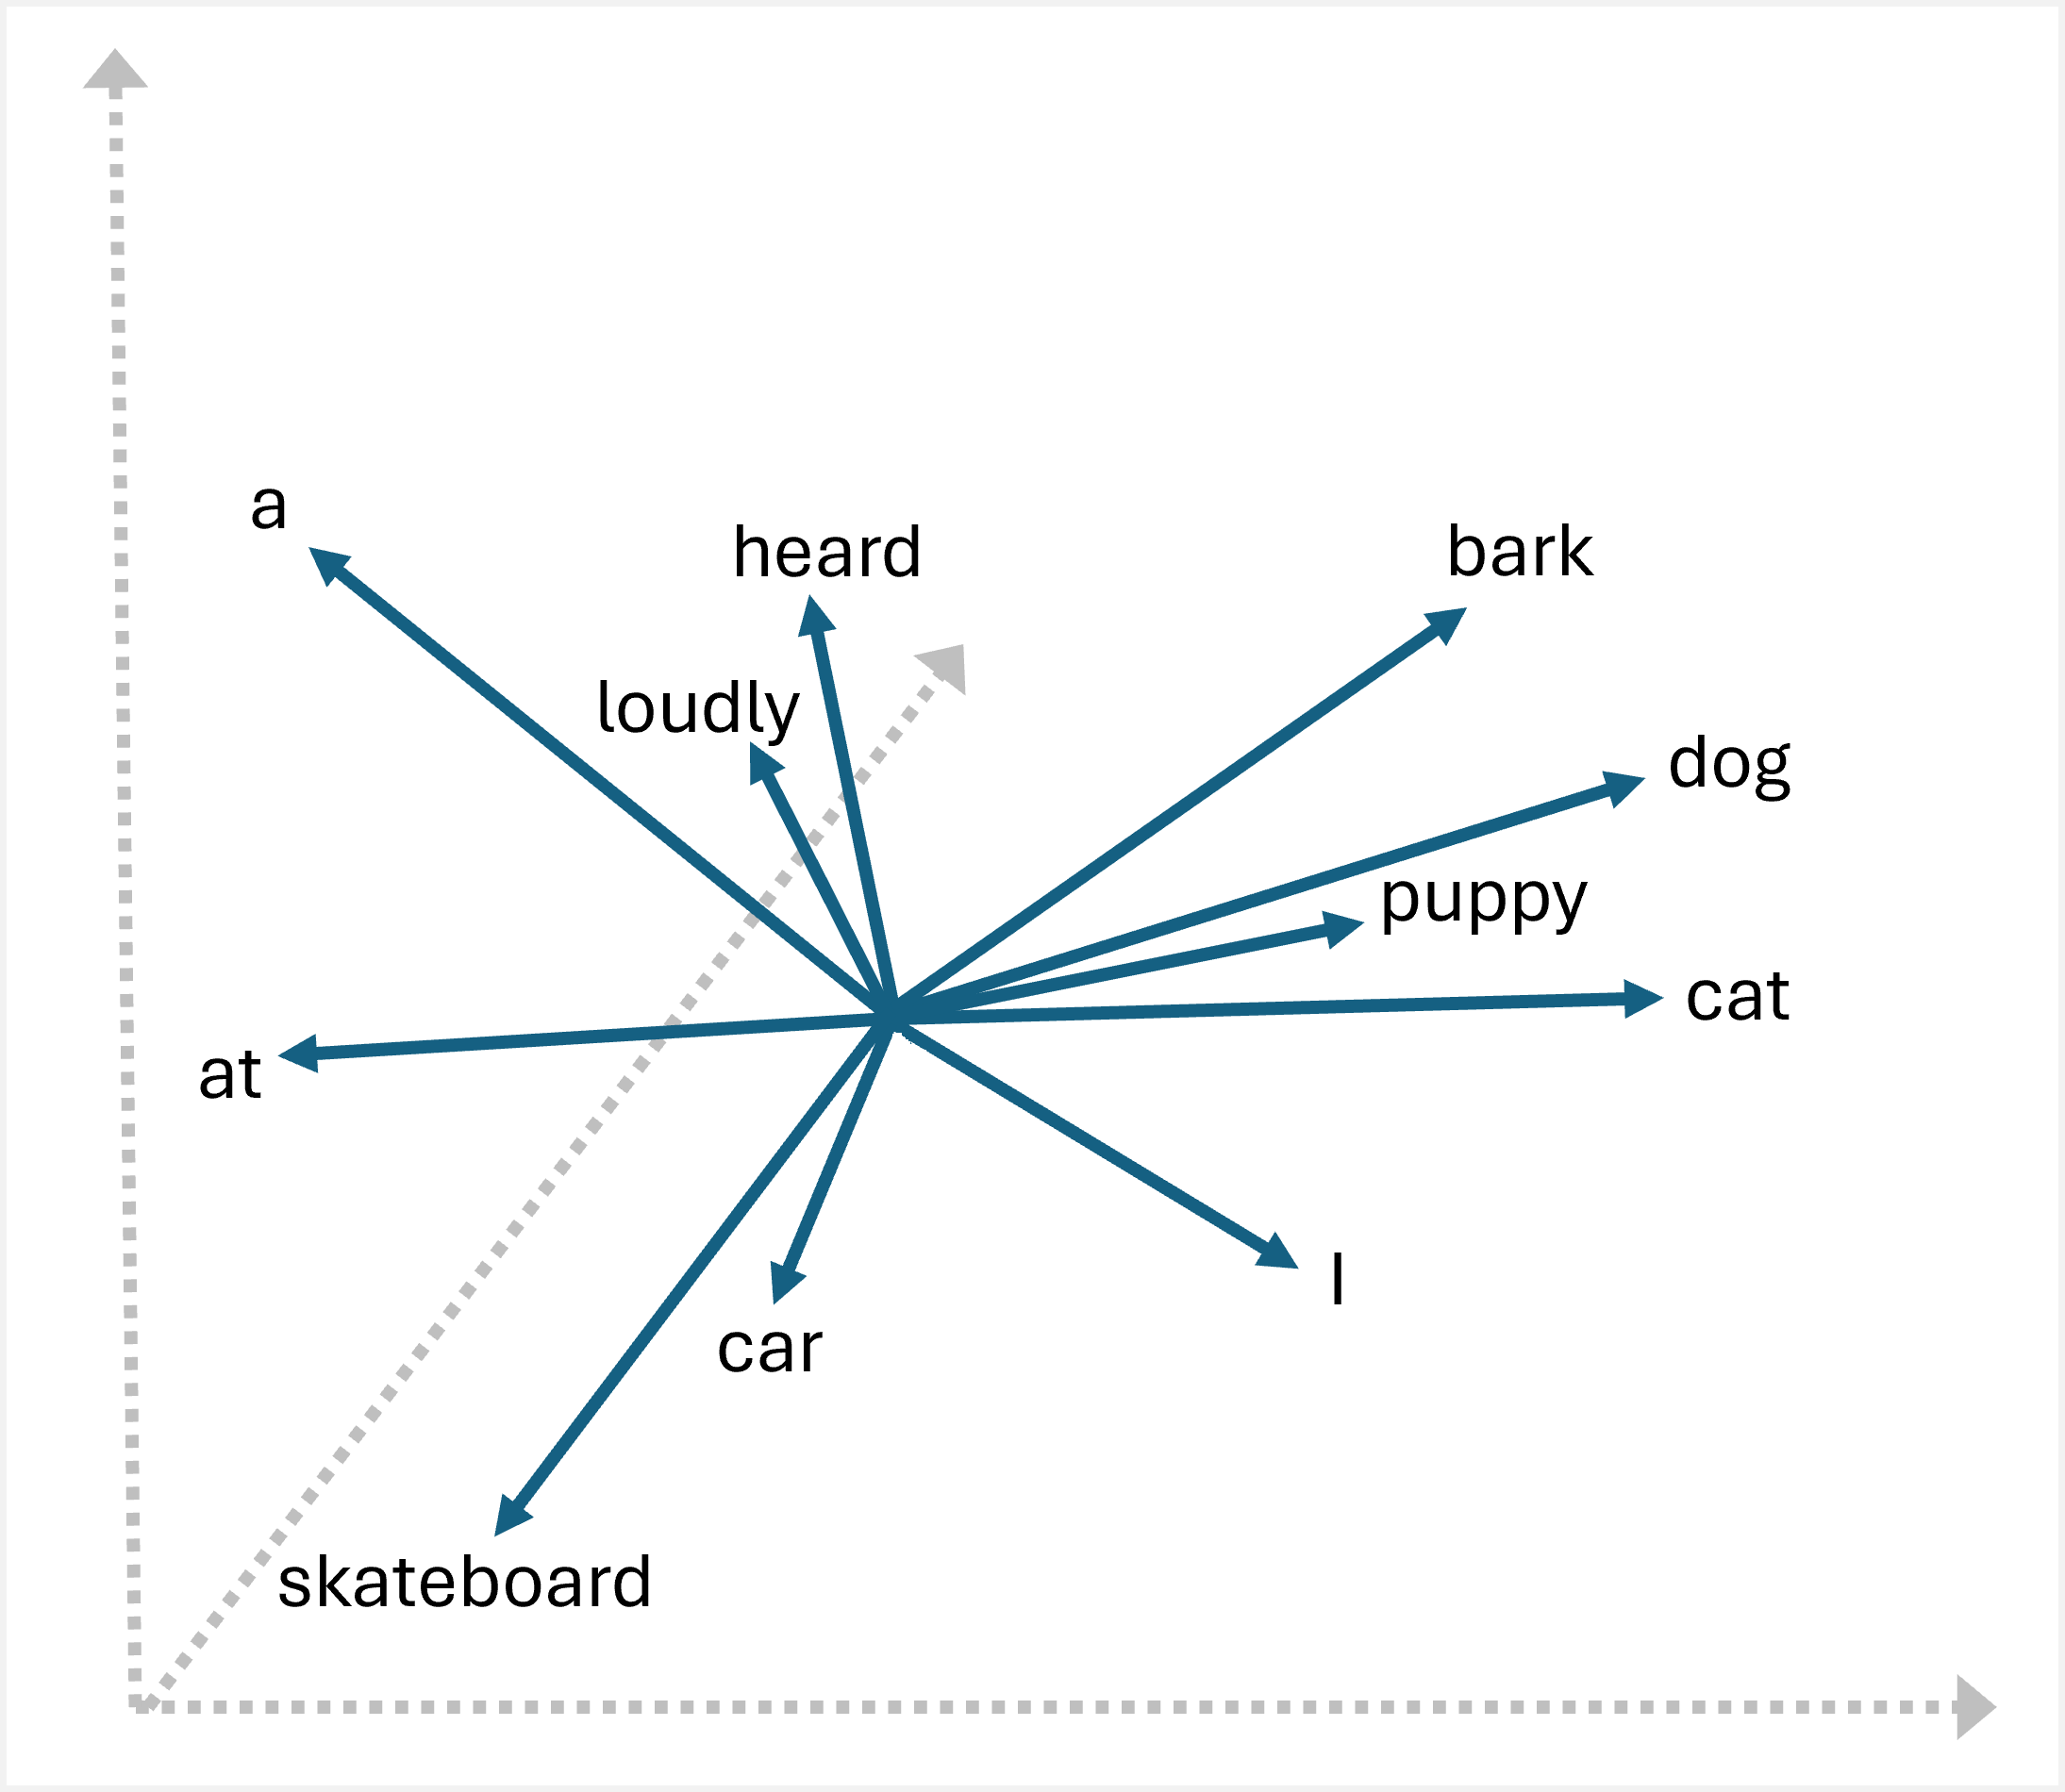
Como podemos ver tokens con significado similar resultan en vectores con direcciones similares.
Podemos calcular cuan cerca están semánticamente unos de otros, usando su cosine similarity.
Predicting completions from prompt
Ahora que tenemos los embeddings que encapsular el contenido semántico de la relación entre tokens, podemos usar el decoder block de un transformer para predecir iterativamente la siguiente palabra en una secuencia comenzada por un prompt.
De nuevo, se usa attention para considerar cada token en contexto; pero ahora el contexto solo incluye los tokens que preceden al token que queremos predecir.