Posts Tagged - AI-901

AI-901: Microsoft Azure AI Fundamentals

(los posts aquí contenidos han sido creados (y contienen imágenes oficiales) siguiendo los cursos oficiales self-paced de learn.microsoft.com AI-901. Para más información recomiendo seguir los mismos cursos)

badge microsoft fundamentals AI-901

status: certified
Microsoft Certified: Azure AI Fundamentals

Contents

Identify AI Concepts and capabilities (40-45%)

  • Describe principles of responsible AI (fairness, reliability, privacy, transparency, accountability)
  • Identify AI model components and configurations
  • Identify AI workloads

Implement AI solutions by using Microsoft Foundry (55-60%)

  • Implement generative AI apps and agents by using Foundry
  • Implement AI solutions for text and speech
  • Implement AI solutions with computer vision and image generation
  • Implement AI solutions for information extraction

Microsoft official learning paths

AI concepts for developers and technology professionals

Microsoft responsible principles

AI

How gen AI works under the hood
Representar texto como vectores
RAG concepts
Prompts & agents

NLP

NLP concepts (techniques)

Information extraction

AI concepts extraction (OCR)

Speech concepts

Speech concepts
Speech recognition (speech-to-text)
Speech synthesis (text-to-speech)

Computer vision

Computer vision
Image processing
Vision transformers & Multimodal models

Get started with AI applications and agents on Azure Foundry

Azure

Understand Azure

AI in Microsoft Foundry

Microsoft Foundry for AI
genAI models in Foundry
Agents in Foundry

Microsoft Foundry by area

Text analysis in Foundry
Speech in Foundry
Computer vision in Foundry
Information extraction with AI (Azure Content Understanding)
Managed Knowledge Layer (Microsoft Foundry IQ)

Labs

Official labs (in python)

Read More

Microsoft Foundry IQ

Microsoft Foundry IQ es una managed knowledge layer para agentes y aplicaciones de IA.

Conecta datos (tanto estructurados como no estructurados) de empresa y datos de la web en bases de conocimiento reutilizables.

Usa agentic retrieval para devolver información relevante y permission-aware con sus referencias.

Es una capa más que tenemos disponible para nuestros agentes

  • Los modelos permiten a los agentes razonar
  • Las tools les permiten ejecutar acciones
  • El Knowledge les otorga información que no está en sus datos de entreno
Componente Proposito
Knowledge base Top level resource. Identifica una colección de Knowledge sources y controla su comportamiento. Acepta prompts de sistema para establecer prioridades o de donde sacar los datos para cada query.
(Ejemplo: Azure AI Search Service)
Knowledge source Una conexión a contenido indexado o remoto.
(Ejemplo: SP, Azure SQL DDBB, Azure Storage, etc.)
Agentic retrieval Retrieval process. En el prompt al agente se le debe indicar cuando debe usar la base de conocimiento.

Read More

Text analysis in Azure (& MCP)

Text analysis es el proceso de extraer información útil de un bloque de texto no estructurado mediante NLP como puede ser:

  • sentiment analysis (positivo, neutral, negativo)
  • entities
  • topics

Text Analysis in Microsoft Foundry

En Foundry tenemos dos aproximaciones para text analysis:

  • modelos generalistas de IA con objetivos muy amplios mediante NLP
  • Tools específicas que devuelven resultados deterministas para tareas muy específicas

Modelos de IA generalistas

Podemos usarlos directamente out-of-the-box para:

  • Key phrase extraction: listar los conceptos principales
  • Entity linking: identificar entidades y linkearlas a Wikipedia
  • Sentiment analysis and opinion mining: identificar si es positivo, neutral o negativo
  • Summarization: resumir la información principal

Los modelos generalistas se recomiendan cuando necesites aplicar varias de estas técnicas a la vez

Azure Language in Foundry Tools

Azure Language is a NLP service for specific text analysis tasks. These analyzers return structured, deterministic output - making them well-suited for automated pipelines where we want consistent results.

Azure Language capabilities:

  • Language detection: evaluates text and detects language and dialect
  • Personal Identifying information (PII) detection (also PHI - health information)

Language detection

given this text

¡Hola! Me llamo Josefo y vivo en Madrid, España

we would get

Language ISO 6391 code Confidence score
Spanish es 1.00

PII detection

given this text

“Maria Garcia called from 020 7946 0958 and asked to send documents to 42 Market Road, London, UK, SW1A 1AA.”

we would get

Text Category
Maria Garcia Person
020 7946 0958 Phone number
42 Market Road, London, UK, SW1A 1AA Address

Use Azure Language with an Agent

AI agents use models as its brain to reason and plan, and they also use tools to perform tasks, which are added as MCP servers.

Model Context Protocol (MCP)

Open standard que define como se conectan los agentes de IA a tools externas y data sources. MCP es un universal adapter para poder conectar agentes a MCP servers que exponen unas capacidades de una manera standard.

MCP usa una arquitectura cliente-servidor

  • El MCP client es el agente de IA que envía requests.
  • El MCP server es el servicio que expone tools, datos o acciones.

Cuando un agente se conecta a un servidor MCP, puede descubrir que tools ofrece ese servidor e invocarlas como necesite.

Un MCP server puede responder a una petición:

  • Providing data (give sentiment scores)
  • Taking action (process a batch of documents)

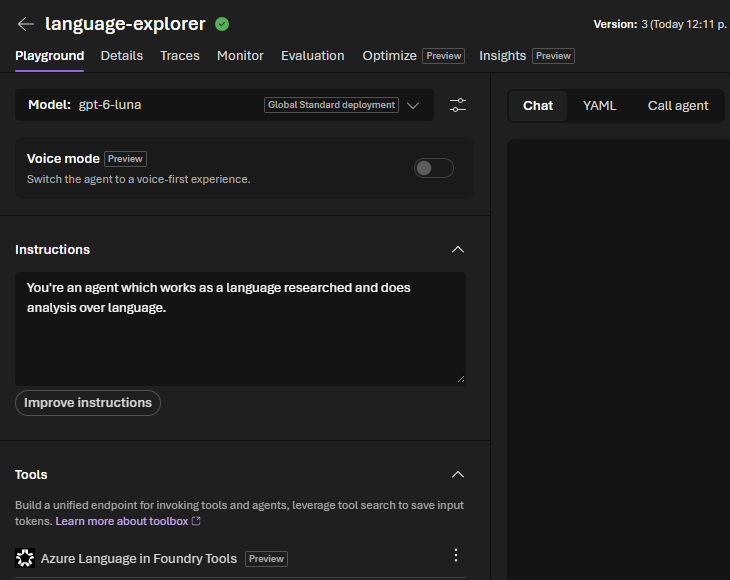
Build your agent in Foundry

Some regions may not be supported for some MCP servers. It happened to me with Azure Language MCP and Spain Central

  1. Deploy a model
  2. Create new agent
  3. Select the deployed model
  4. Give instructions to the agent
  5. Linked the previously created tools (Azure Language)
  6. Give a prompt and test

test analysis agent

Client application to analyze text (python)

Let’s create an application that uses the OpenAI Python SDK. For that we need to have created before:

  • a Foundry resource
  • a Foundry project

Install the main library

pip install openai

Create a config file .env

AZURE_OPENAI_ENDPOINT=https://<your-resource>.openai.azure.com/openai/v1/
MODEL_DEPLOYMENT_NAME=gpt-4.1-mini
API_KEY=<your-foundry-key>

Create the app logic

import os
from dotenv import load_dotenv
from openai import OpenAI

# Load environment variables from .env file
load_dotenv()
endpoint = os.getenv("AZURE_OPENAI_ENDPOINT")
api_key = os.getenv("API_KEY")
deployment_name = os.getenv("MODEL_DEPLOYMENT_NAME")

# Create the client object
client = OpenAI(
    base_url=endpoint,
    api_key=api_key
)

# Make a request using the client
message = client.responses.create(
    model=deployment_name,
    input="",
)

# Print the results
print(f"Sentiment: {message.output[0]}")

Use the Azure Language SDK

Install it

pip install azure-ai-textanalytics

Adapt the config

AZURE_LANGUAGE_ENDPOINT=https://<your-resource>.cognitiveservices.azure.com/
API_KEY=<your-foundry-key>

App code for language detection

# Import packages
import os
from dotenv import load_dotenv
from azure.core.credentials import AzureKeyCredential
from azure.ai.textanalytics import TextAnalyticsClient

# Load environment variables from .env file
load_dotenv()
endpoint = os.getenv("AZURE_LANGUAGE_ENDPOINT")
key = os.getenv("API_KEY")

# Create the client
client = TextAnalyticsClient(endpoint=endpoint, credential=AzureKeyCredential(key))

# Make a request using the method for LANGUAGE DETECTION
text = "¡Hola! Me llamo Josefina y vivo en Madrid, España."
result = client.detect_language([text])[0]

# Print the results
print(f"Language      : {result.primary_language.name}")
print(f"ISO code      : {result.primary_language.iso6391_name}")
print(f"Confidence    : {result.primary_language.confidence_score:.2f}")

Or if we modify the method called, for PII

# Make a request using the method for PII
text = "Maria Garcia called from 020 7946 0958 and asked to send documents to 42 Market Road, London, UK, SW1A 1AA."
result = client.recognize_pii_entities([text])[0]

# Print the results
print("Redacted text:", result.redacted_text)
print("\nEntities found:")
for entity in result.entities:
    print(f"  {entity.text} | category={entity.category} | confidence={entity.confidence_score}")

Read More

Speech in Azure

We split speech in two capabilities:

  • Speech recognition (speech-2-text)
  • Speech synthesis (text-2-speech)

Speech recognition (speech-2-text)

Speech-to-text software includes multiple models

  • An acoustic model that converts audio into phonemes
  • A language model that maps phonemes to words

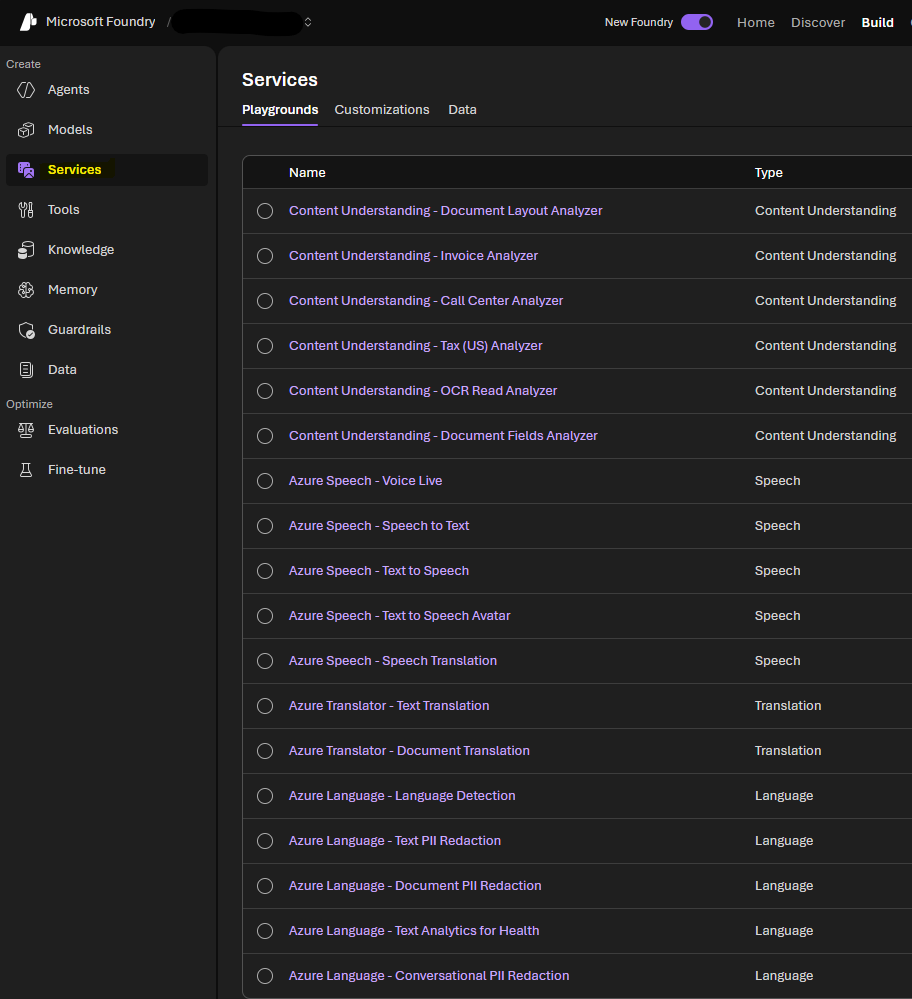
Go to Build > Services and there we can choose the one we want to use

speech Azure

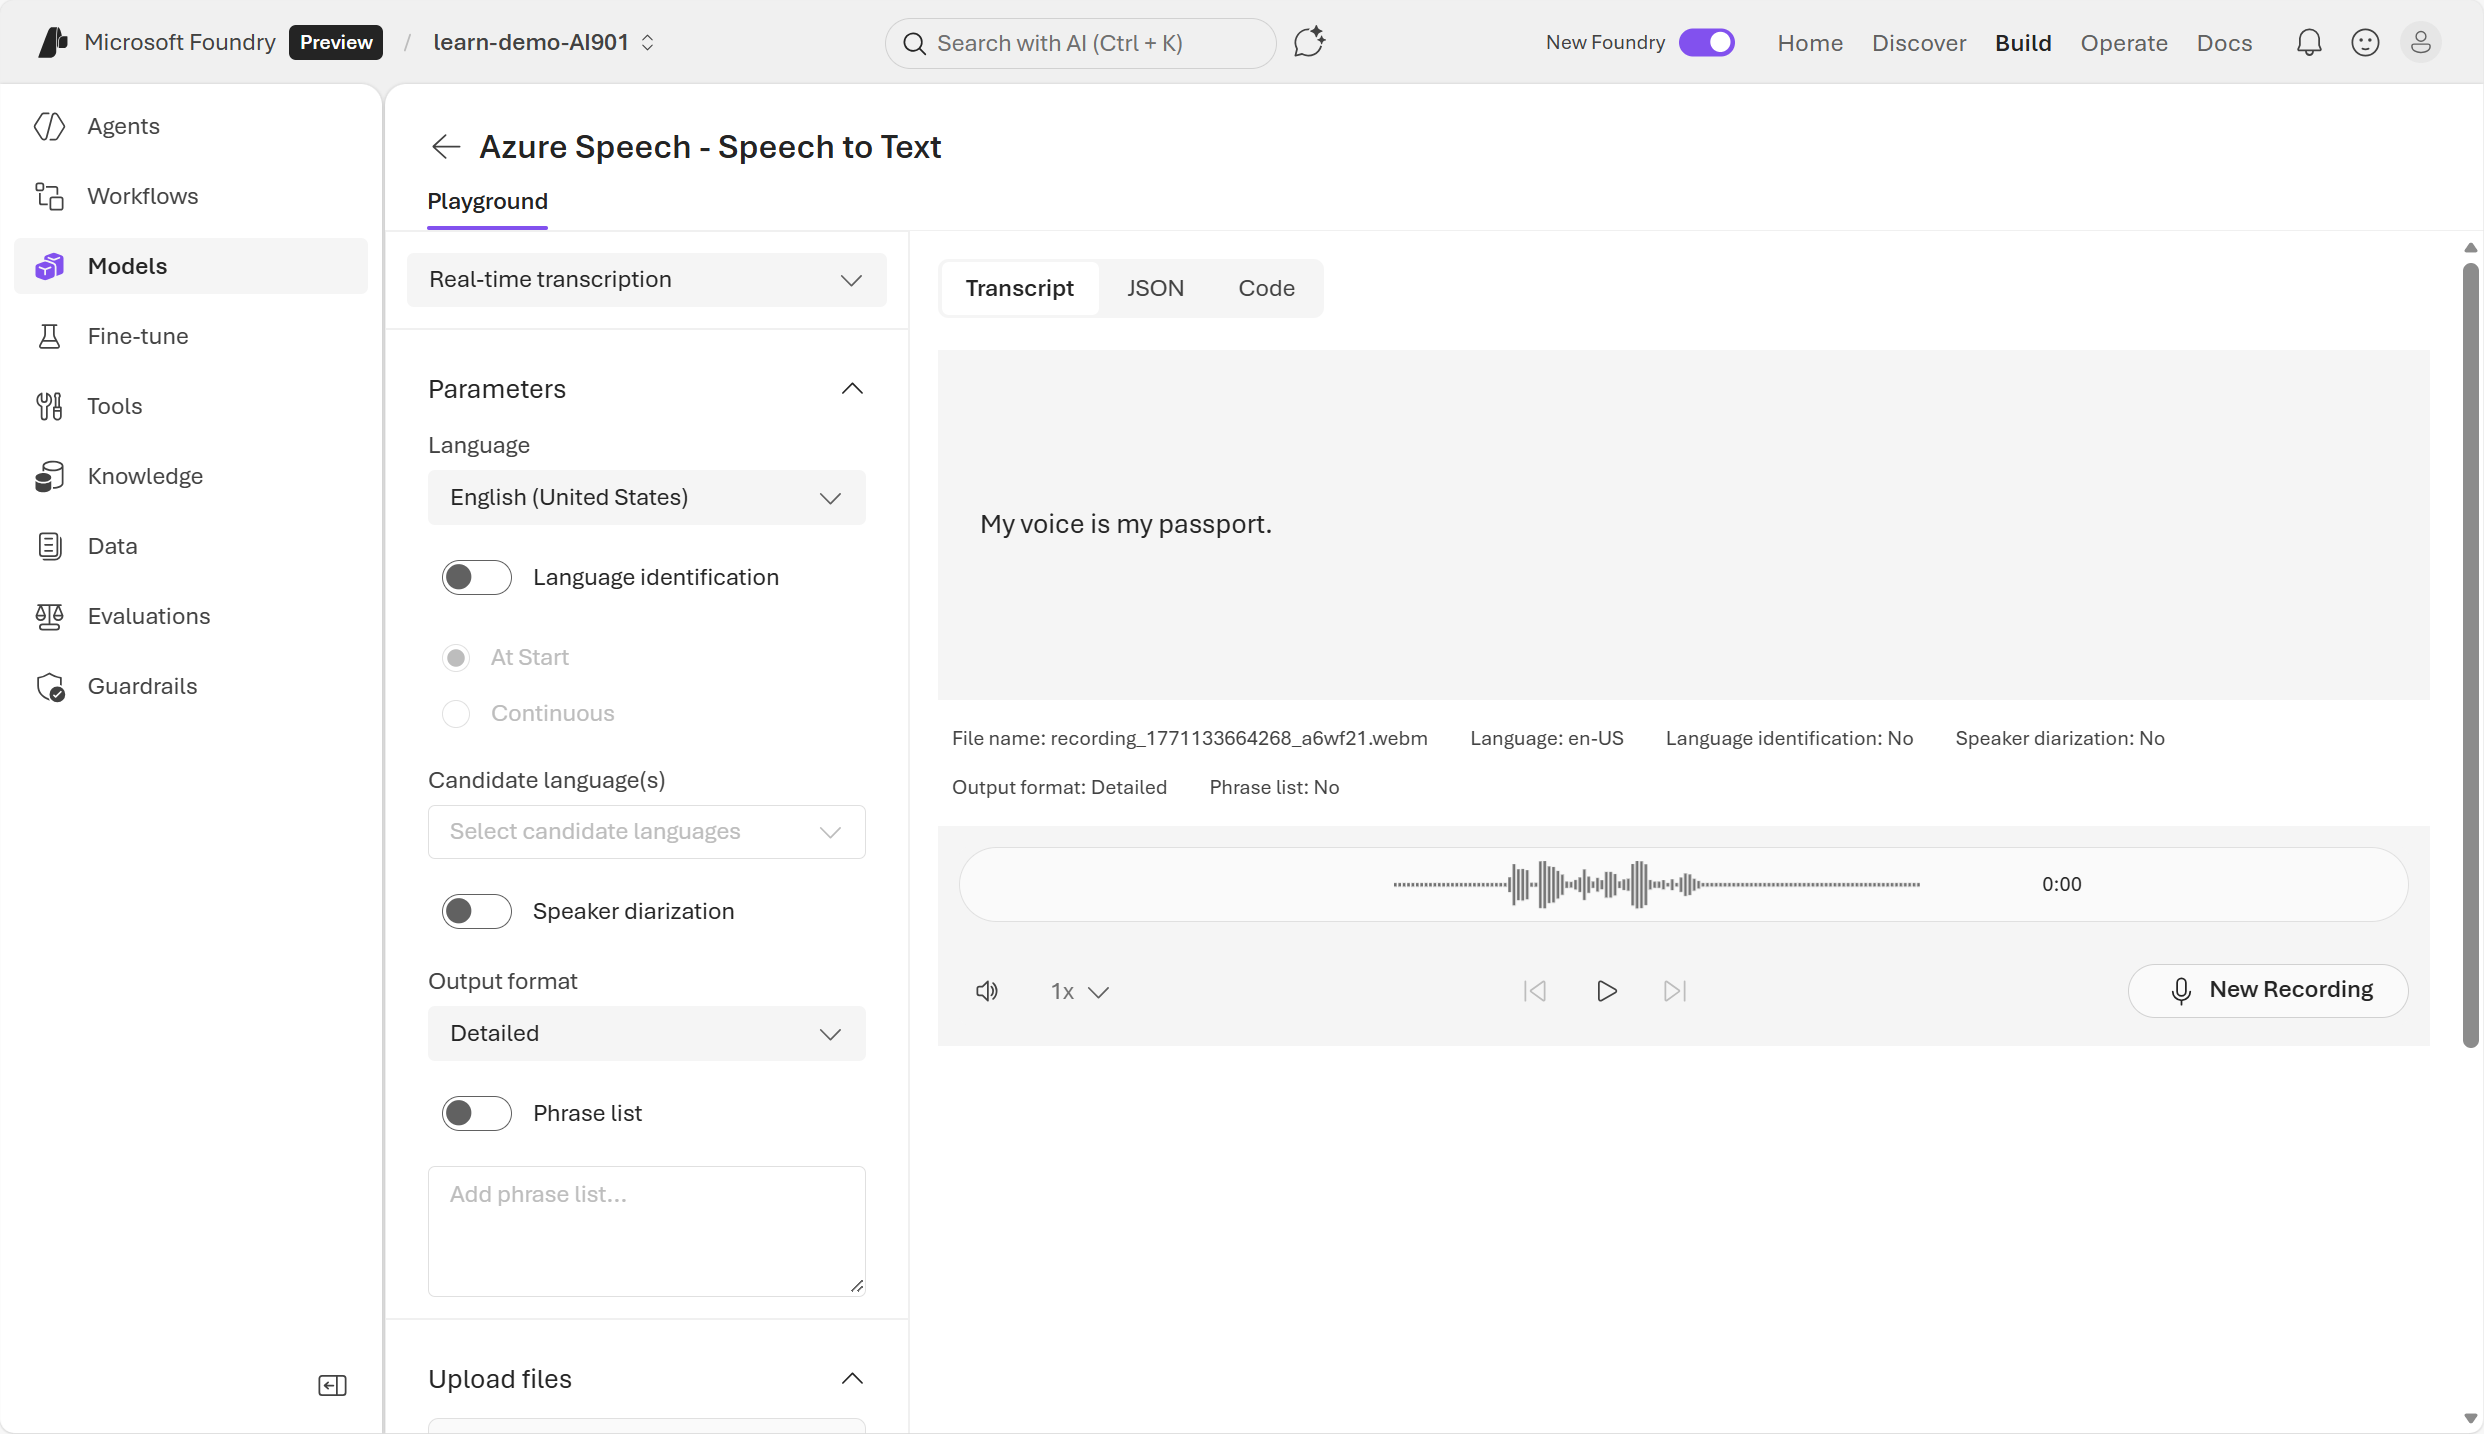
Then if we open Speech-to-text, you can speak there and test the service

speech to text example

Azure speech-to-text SDK

It’s also possible to use it through the SDK for application’s usage.

Install the SDK

pip install azure-cognitiveservices-speech

App code

import azure.cognitiveservices.speech as speechsdk

# Set up the speech config using resource endpoint
endpoint_url = "ENDPOINT"
speech_key = "FOUNDRY_KEY"

speech_config = speechsdk.SpeechConfig(
    subscription=speech_key,
    endpoint=endpoint_url
)

# Create a recognizer with microphone input
audio_config = speechsdk.audio.AudioConfig(use_default_microphone=True)
speech_recognizer = speechsdk.SpeechRecognizer(
    speech_config=speech_config, 
    audio_config=audio_config
)

# Event handlers
def recognized_handler(evt):
    print(f"Recognized: {evt.result.text}")

def recognizing_handler(evt):
    print(f"Recognizing: {evt.result.text}")

# Connect event handlers
speech_recognizer.recognized.connect(recognized_handler)
speech_recognizer.recognizing.connect(recognizing_handler)

# Start continuous recognition
speech_recognizer.start_continuous_recognition()
print("Say something...")

# Keep the program running
input("Press Enter to stop...")
speech_recognizer.stop_continuous_recognition()

When using the SDK it’s possible to perform real-time or batch transcription of audio which work as async jobs with audios you’ve saved.

Batches usually should be immediate but they work on a best-effort basis. Normally they start within minutes of the request but this is NOT guaranteed

Speech synthesis (text-2-speech)

A text-to-speech solution usually requires:

  • the text to be spoken
  • the voice to be used to vocalize the speech

To synthesize speech the system typically:

  1. Tokenizes the text to break it down into individual words
  2. Breaks the phonetic transcription into prosodic units (such as phrases, clauses or sentences)
  3. Creates phonemes from the prosodic units
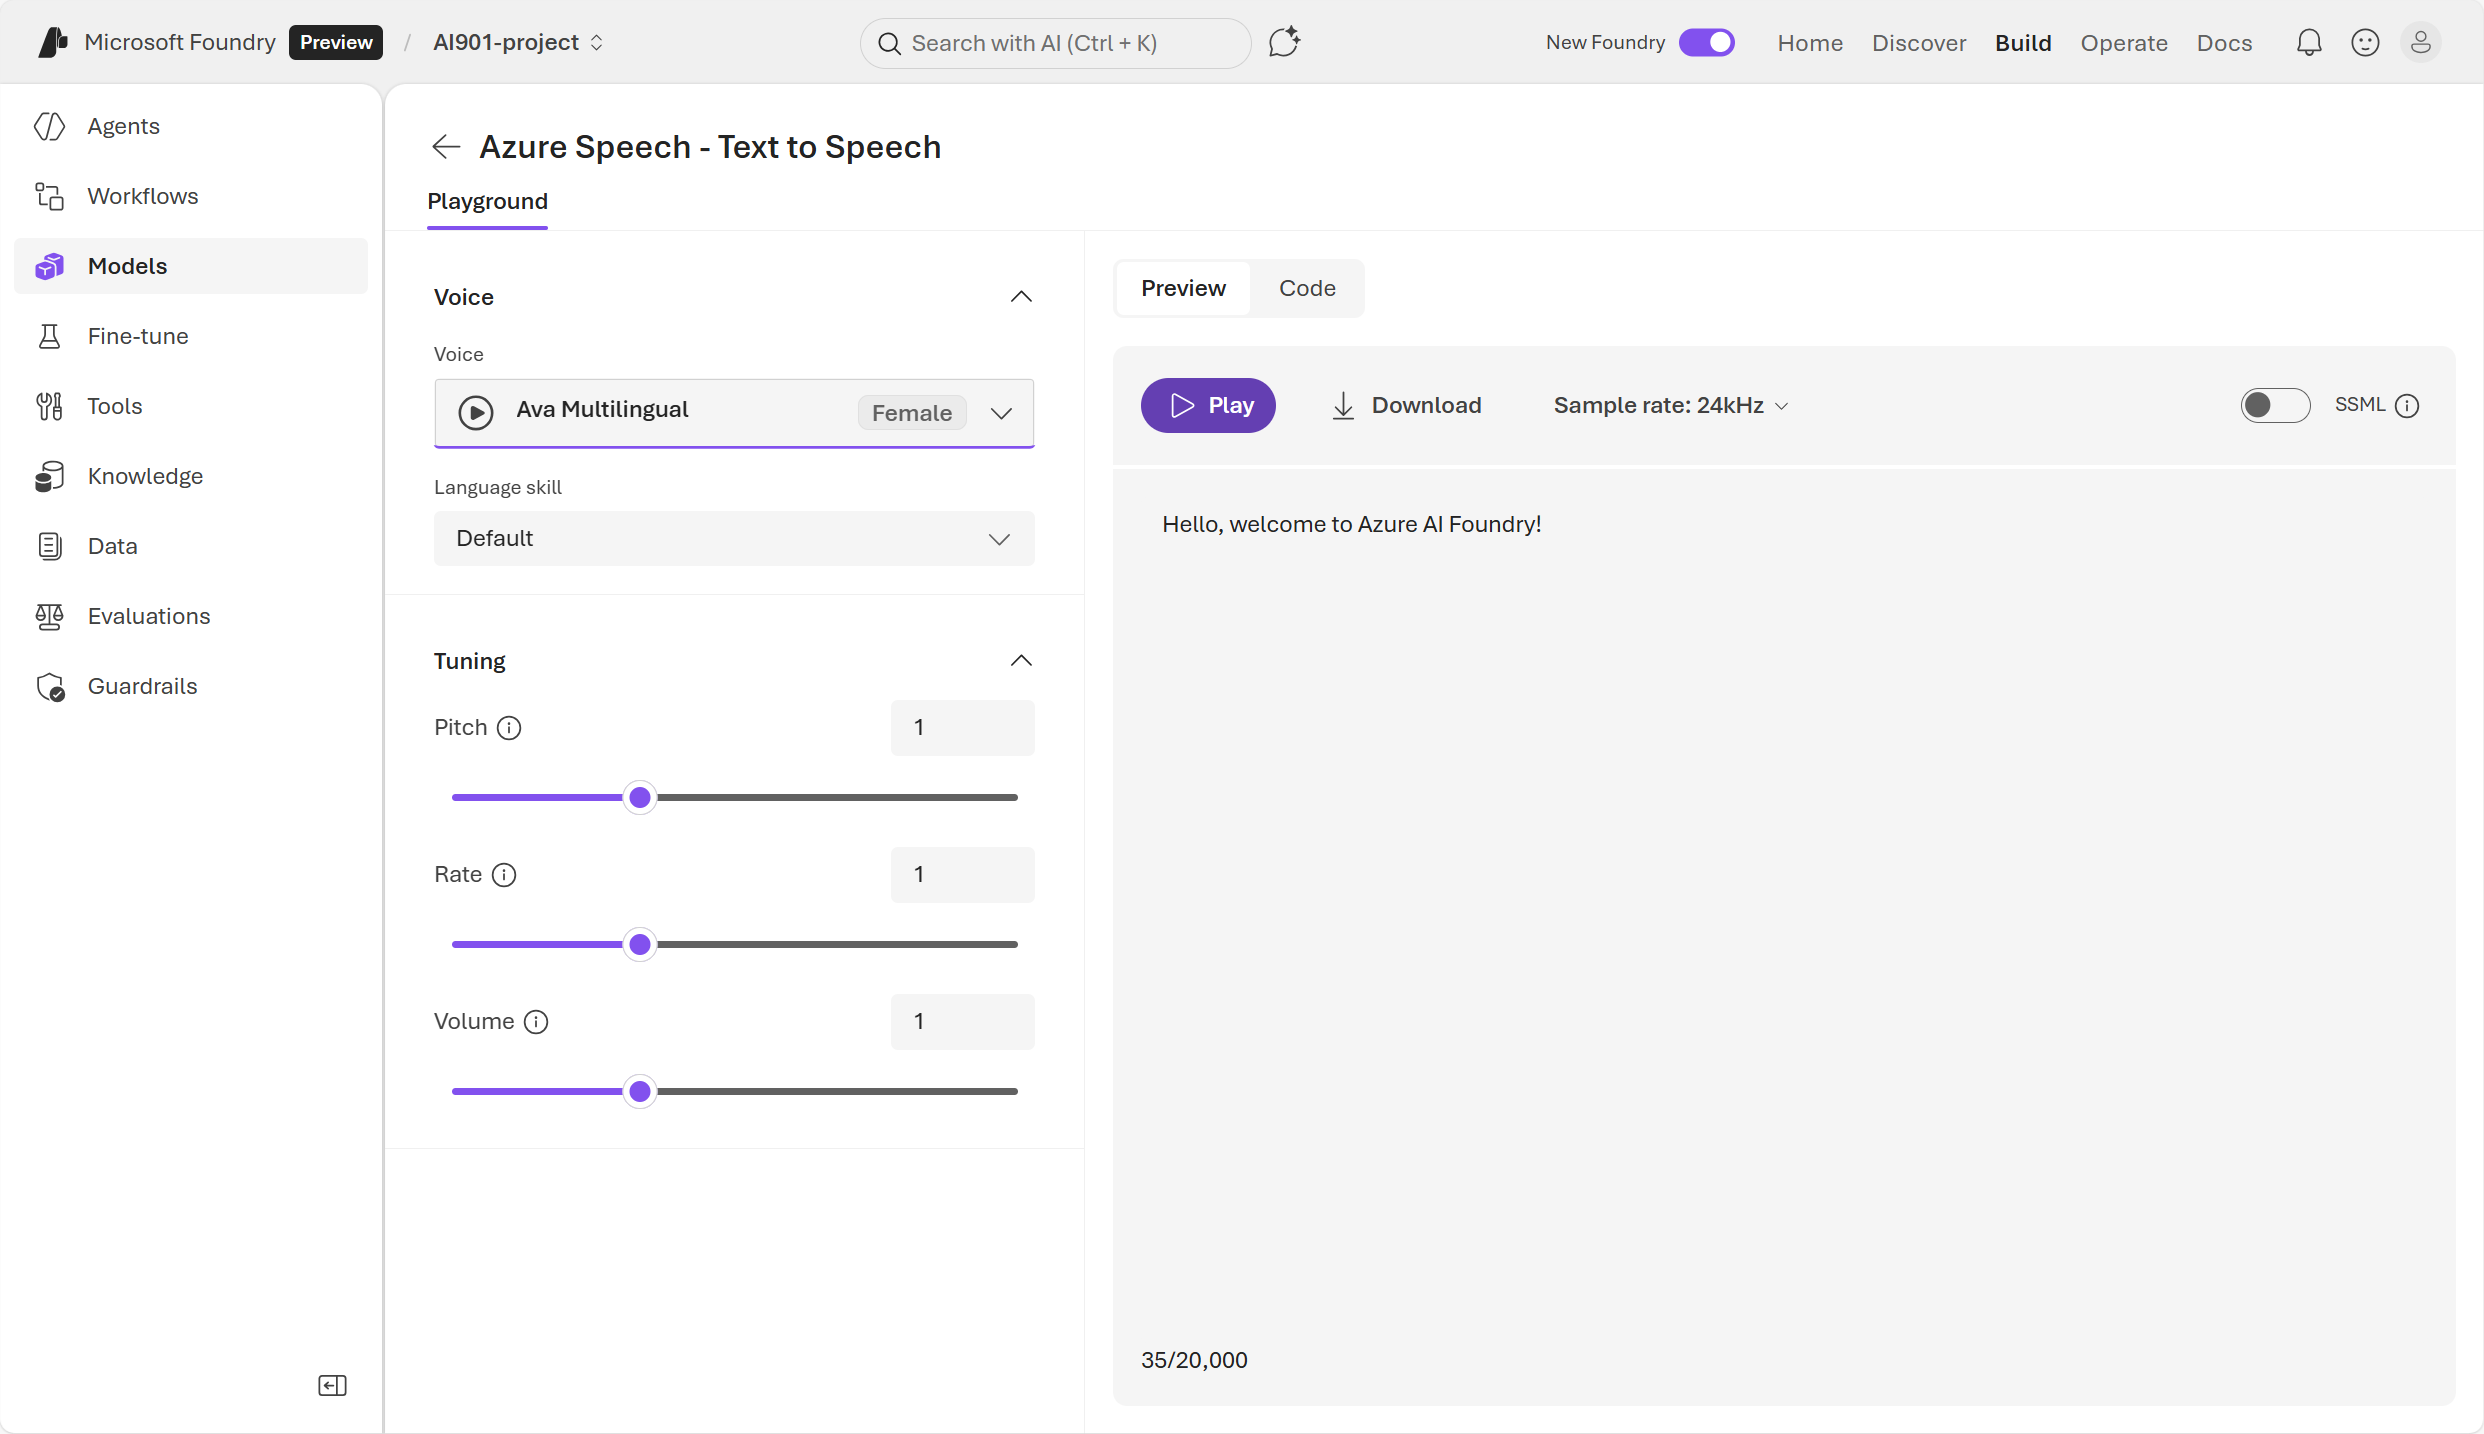
  4. The phonemes are synthesized as audio and can be assigned a particular voice, speaking rate, pitch and volume

text to speech example

Azure text-to-speech SDK

code example

import os
import azure.cognitiveservices.speech as speechsdk

# This example requires environment variables named "FOUNDRY_KEY" and "ENDPOINT"
speech_config = speechsdk.SpeechConfig(subscription=os.environ.get('FOUNDRY_KEY'), endpoint=os.environ.get('ENDPOINT'))
audio_config = speechsdk.audio.AudioOutputConfig(use_default_speaker=True)

# The neural multilingual voice can speak different languages based on the input text.
speech_config.speech_synthesis_voice_name='en-US-Ava:DragonHDLatestNeural'

speech_synthesizer = speechsdk.SpeechSynthesizer(speech_config=speech_config, audio_config=audio_config)

# Get text from the console and synthesize to the default speaker.
print("Enter some text that you want to speak >")
text = input()

speech_synthesis_result = speech_synthesizer.speak_text_async(text).get()

if speech_synthesis_result.reason == speechsdk.ResultReason.SynthesizingAudioCompleted:
    print("Speech synthesized for text [{}]".format(text))
elif speech_synthesis_result.reason == speechsdk.ResultReason.Canceled:
    cancellation_details = speech_synthesis_result.cancellation_details
    print("Speech synthesis canceled: {}".format(cancellation_details.reason))
    if cancellation_details.reason == speechsdk.CancellationReason.Error:
        if cancellation_details.error_details:
            print("Error details: {}".format(cancellation_details.error_details))
            print("Did you set the speech resource key and endpoint values?")

Crear un agente speech-capable

Azure Speech incluye un VoiceLive Service el cual permite construir agentes conversacionales. Esta API permite tener conversaciones en tiempo real.

VoiceLive Service API reune todo para que el agente pueda escuchar y pueda responder.

agente capaz de speech

Esto también se puede usar programáticamente mediante el SDK

pip install azure-ai-voicelive

Read More

Computer vision in Azure

Modelos multimodales para análisis de imagen

Cada vez hay más modelos multimodales los cuales aceptan ambos textos e imágenes. Esto reduce la necesidad de tener vision pipelines separadas.

Foundry soporta el uso de modelos multimodales desde la web (Azure OpenAI API).

Azure OpenAI SDK (python)

Instalar el sdk

pip install openai

Ejemplo de código

import os
from openai import OpenAI

# Environment variables you set locally or in your app service:
FOUNDRY_KEY = "... your key ..."
ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/"
MODEL_NAME = "your-model-deployment-name"  # e.g., "gpt-4.1-mini" deployed as "my-vision-deploy"

client = OpenAI(
    api_key=os.getenv("FOUNDRY_KEY"),
    base_url=os.getenv("ENDPOINT"),
)

image_url = ""

response = client.responses.create(
    model=os.getenv("MODEL_NAME"),  # your deployment name 
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "What is in this image? Provide 3 bullet points."},
                {"type": "input_image", "image_url": image_url}
            ],
        }
    ],
)

print(response.output_text)

Generación de imágenes

Foundry contiene modelos especiales para generación de imagen

  • GPT-Image-1.5
  • GPT-Image-1
  • GPT-Image-1-Mini

Todos estos modelos se pueden usar desde Foundry o con el SDK

OpenAI SDK

Código App

import os
import base64
from openai import OpenAI

# Required environment variables (example names)
FOUNDRY_KEY="..."
ENDPOINT="https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/"
MODEL_NAME="your-gpt-image-deployment-name"  # e.g., "gpt-image-1"

client = OpenAI(
    api_key=os.environ["FOUNDRY_KEY"],
    base_url=os.environ["ENDPOINT"],
)

prompt = "A modern flat illustration of a robot holding a potted plant, clean vector style, pastel colors."

response = client.responses.create(
    model=os.environ["MODEL_NAME"],  # your deployment name in Foundry
    input=prompt,
    tools=[{"type": "image_generation"}],
)

image_base64 = next(
    item.result for item in response.output
    if item.type == "image_generation_call"
)

with open("foundry_generated.png", "wb") as f:
    f.write(base64.b64decode(image_base64))

print("Saved: foundry_generated.png")

Generación de videos

Foundry contiene modelos especiales para generación de imagen

  • Sora 2
  • Sora 1

REST interface

Se puede usar la REST interface para integrar el servicio de generación de videos con una aplicación

ejemplos curl

crear video

curl -X POST "https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/videos" \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "sora-2",
    "prompt": "A cinematic close-up of raindrops sliding down a neon-lit window at night.",
    "size": "1280x720",
    "seconds": "8"
  }'

poll status

curl -X GET "https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/videos/{video_id}" \
  -H "api-key: $AZURE_OPENAI_API_KEY"

download video

curl -L "https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/videos/{video_id}/content?variant=video" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  --output output.mp4

Read More

Information Extraction with AI (Azure Content Understanding)

Extract information from documents

Azure Content Understanding

LEARN what Azure Content Understanding is and how it works

Azure Content Understanding goes beyond simple OCR text extraction. It follows a schema-based extraction of fields and values.

It follows this workflow

  1. Ingest content
  2. AI-powered analysis: The services analyzes the content through combination of
    • OCR
    • speech recognition
    • NLP/NLU
    • multimodal AI models
  3. Structured output - returns for example JSON

Understand analyzers

Un analyzer es una unidad de Azure Content Understanding la cual:

  • toma input
  • aplica analisis mediante IA
  • produce un resultado estructurado

Una vez estructurado un analyzer se encarga de que un schema sea reusado de manera consistente para cada request. Un analyzer produce resultados predecibles en JSON.

Azure Content Understanding ofrece prebuilt analyzers o se pueden customizar. A alto nivel:

  1. Eliges o creas un analyzer
  2. El analyzer incluye un schema que define los campos y su estructura
  3. Adjuntas contenido para ser analizado
  4. El servicio aplica el schema
  5. Recibes JSON de vuelta que concuerda con el schema

Read More

Understand Azure

Azure provee de 4 categorías de servicios:

  • Compute: run applications or workloads in the cloud
  • Storage: it lets you save and manage data in the cloud
  • Networking: tools that connect your cloud resources to each other, the internet or your organization
  • App Services: IaaS / PaaS

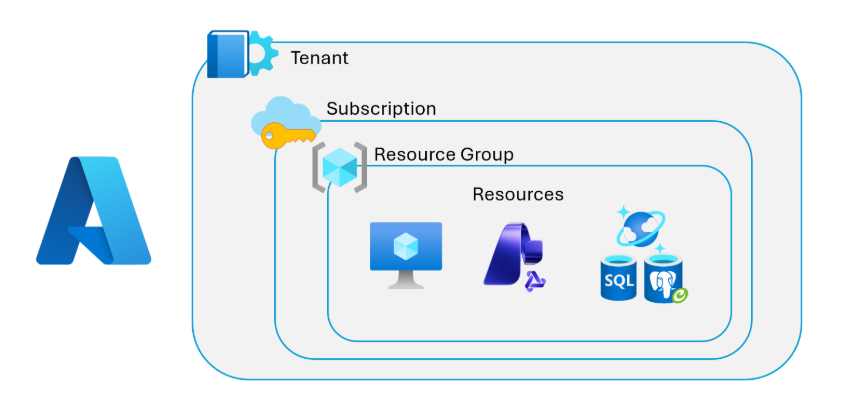
Estructura organizacional de Azure

(Azure se organiza en)

embeddings representation

Tenants

Un tenant es la base de una organización en Azure Cloud. Microsoft crea un tenant cuando una compañía se registra en Azure y cada tenant es independiente de otros.

El tenant incluye:

  • users
  • groups
  • identidades
  • policies

Read More

Microsoft Foundry for AI

Microsoft Foundry es un PaaS unificado para construir, administrar y hacer deployment de AI apps y agentes. Consolida modelos, orquestación de agentes, monitoring y governanza en una plataforma.

Foundry ofrece muchas capacidades, incluyendo el elegir uno de muchos modelos, usar estos modelos para construir agentes, conectar esos agentes a herramientas e integrar knowledge usando Foundry IQ (punto de acceso centralizado para data sources)

microsoft foundry

Foundry resources and projects

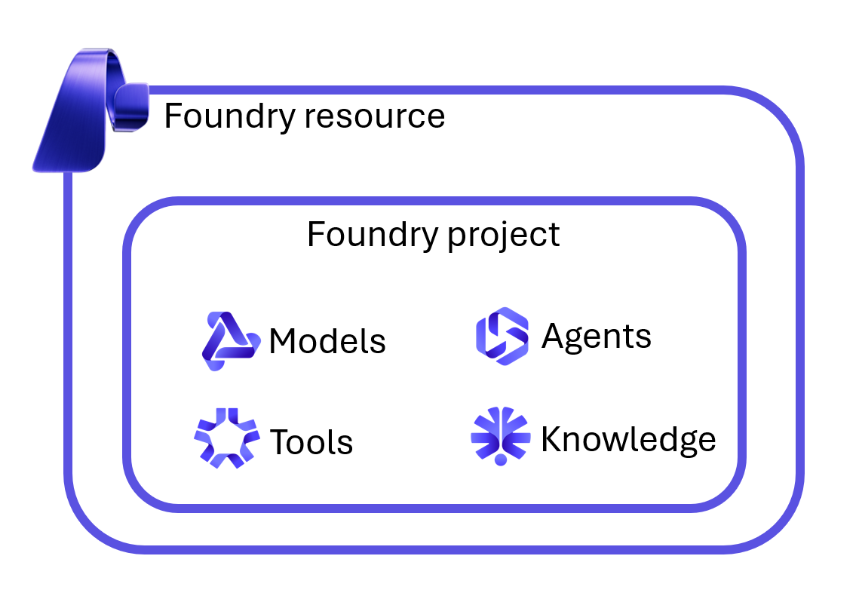
Para empezar con Foundry hay que crear un Foundry resource, el cual provee de acceso a:

  • modelos
  • agent service
  • deployment governance
  • monitoring and observability
  • security boundaries
  • quotas and operational controls

Un Foundry project es un workspace dentro de ese resource donde construyes AI apps, agentes y evaluaciones:

  • agentes
  • evaluaciones
  • files and datasets
  • vector indexes
  • flows (AI logic)
  • connections
  • project-specific settings

De normal tenemos un Foundry resource para un equipo o departamento, y muchos Foundry projects dentro, cada uno enfocado a un caso de uso de IA distinto

Read More

Labs

Microsoft Foundry - general

  1. Crear un Microsoft Foundry resource y su project
  2. Desplegar y probar un modelo desde la web
  3. Acceso programático mediante Foundry SDK al modelo
  4. Desplegar y probar un agente desde la web
  5. Acceso programático mediante Foundry SDK al agente

Text analysis

  1. Deploy a general model, search for a medium to long text block and perform the following techniques:

    • Key phrase extraction: listar los conceptos principales
    • Entity linking: identificar entidades y linkearlas a Wikipedia
    • Sentiment analysis and opinion mining: identificar si es positivo, neutral o negativo
    • Summarization: resumir la información principal
  2. Deploy and use a MCP server (Azure Language)

Speech

  1. Deploy and test text-to-speech and speech-to-text

Computer vision

  1. Deploy and test image and video generation

Azure Content Understanding

  1. Deploy and test documents/audio/video analysis

Foundry IQ

  1. Deploy, test, and connect an agent

Read More

GenAI Models in Foundry

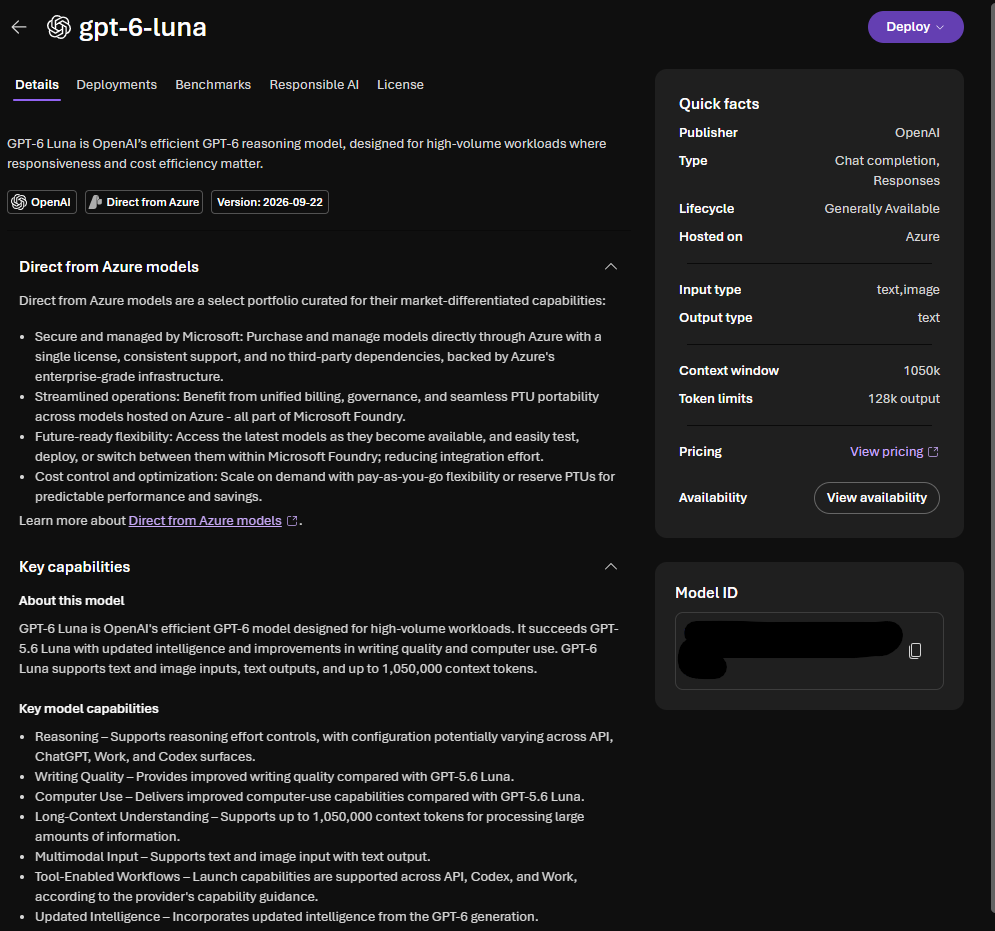
Microsoft Foundry has a model catalog that includes various model types

  • Models sold directly by Azure: models hosted directly by Microsoft. High integration with Azure and SLAs / compliance
  • Models from Partners and the Community: includes open-source or vendor-hosted models. They support broader experimentation and innovation.

Each model entry includes:

  • description and capabilities
  • Benchmark results and performance comparison against other models
  • Supported inference tasks and fine-tuning options
  • Responsible model AI documentation

model description

LEARN THIS definition:

Foundation models are large, pretrained models that provide general language, reasoning or multimodal capabilities out of the box. These models can be deployed immediately or customized through fine-tuning, and serve as the base layer for building AI apps.

Read More

Agents in Foundry

Los agentes son aplicaciones que usan la IA generativa. La IA agentica se aleja de prompts individuales y en vez de eso define comportamientos consistentes (workflows) que se pueden reutilizar a través de aplicaciones y servicios.

Un agente en Foundry consta de:

  • Modelo: el cerebro
  • Instrucciones: system prompt que define su rol, comportamiento, estilo, constricciones y output
  • Tools: acciones que el agente puede realizar

Los agentes pueden:

  • Llamar external tools (APIs, funciones, retrieval) por su cuenta
  • Estructurar tareas paso a paso
  • Tener memoria de una conversación
  • Procesar user input, decidir acciones y generar output estructurado

Crear un agente en Foundry

  1. Elegimos que modelo queremos usar
  2. Escribimos el system prompt
  3. Añadimos tools
  4. Añadimos knowledge

Add Tools

Las Tools en Foundry permiten a un modelo ejecutar acciones llamando a sistemas externos. Representan acciones ejecutables (navegar internet, query a BBDD, usar un MCP server)

  • Code interpreter
  • Custom APIs

En Foundry las tools forman la base de las acciones para los agentes. Se pueden configurar centralmente en el Foundry Tool Catalog

Read More

RAG concepts

RAG (Retrieval Augmented Generation) es una técnica que complementa el prompt con información de diferentes fuentes de conocimiento externas, como documentos o emails, para aumentar el prompt con datos relevantes y basar la respuesta en esas fuentes.

La respuesta del modelo se basará en la información proveída (data grounding) y sirve para suplir carencias en los datos de entrenamiento de los modelos o para complementarlos con datos propietarios.

Index data

La búsqueda solo puede encontrar la información que previamente se ha indexado. Antes de que el RAG pueda responder preguntas, necesita una indexing pipeline que prepare los datos

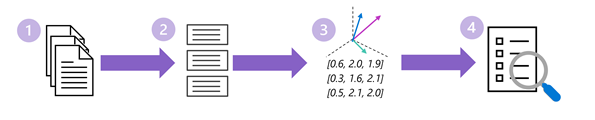
RAG indexing

  1. Select source data
  2. Hacer chunking
  3. Hacer encoding de text tokens a embeddings
  4. Crear un index donde se puedan buscar estos embeddings

Select and process source data

Limpiar y procesar todos los documentos de entrada

  1. Cargar contenido de sus fuentes
  2. Extraer texto útil y estructurarlo
  3. Limpiar el contenido (remover headers repetidos, navigation text, etc )
  4. Añadir metadatos (título, source URL, categoría, etc)

Read More

AI concepts extraction

Esto se utiliza para extraer datos estructuradas desde media no estructurada como documentos, imágenes, audio o vídeo.

Optical Character Recognition (OCR)

Tecnología que convierte formatos visuales en texto.

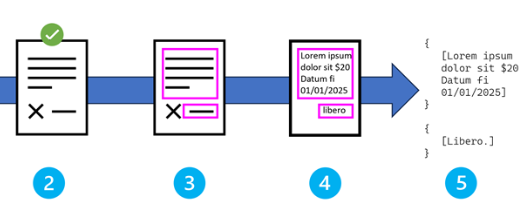
OCR flow

  1. Preprocesamiento y mejoras de la imagen
  2. Detección de zonas de texto
  3. Character recognition and classification
  4. Output generation and post processing

Preprocesamiento e image enhancement

Antes de comenzar con la detección de texto se aplican técnicas para optimizar y mejorar la imagen

  • Noise reduction: remueve artefactos visuales, polvo o imperfecciones.
  • Contrast adjustment: mejora el contraste entre texto y fondo
  • Correción de desvíos (horizonte): alinea la rotación del documento
  • Resolution optimization

Text region detection

El sistema identifica las áreas que contienen texto usando las siguientes técnicas

  • Layout analysis: distingue entre zonas de texto, imágenes o gráficos y zonas en blanco
  • Text block identification: agrupa caracteres en palabras, lineas y parrafos
  • Reading order determination: de izq a derecha, top to bottom o viceversa
  • Region classification: identifica headers, body text, tables

Read More

Vision transformers & Multimodal models

Semantic model for images - Vision transformers

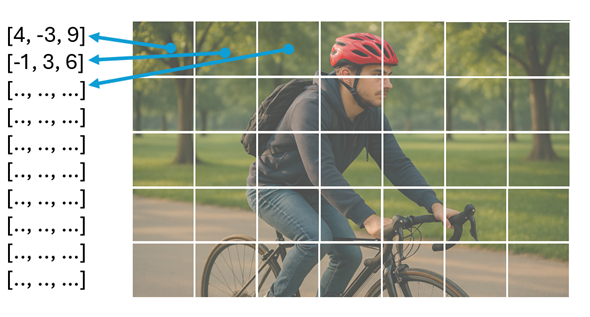
The same way we have transformers for embeddings to hold semantic meaning, we use vision transformer models, in which a model is trained using large volume of images. Instead of encoding text-based tokens, the transformer extracts patches of pixel values from the image, and generates a linear vector from the pixel values.

vision transformer

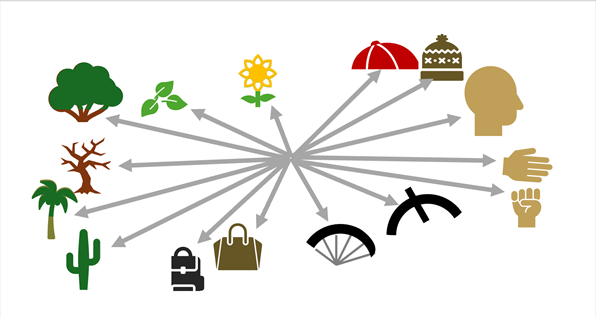
La misma técnica de attention que se usa en LLMs para los embeddings de relacionar contenido semántico, se usa aquí para relacionar los patches según diferentes características visuales como color, forma, contraste, textura, etc.

visual_embeddings

Los embeddings son embeddings, da igual si se crearon a partir de texto o de imágenes. Son vectores donde contenido relacionado tendrán direcciones similares.

Read More

Image processing

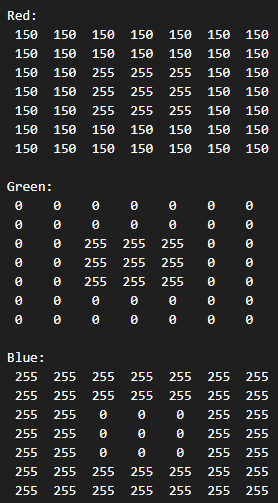
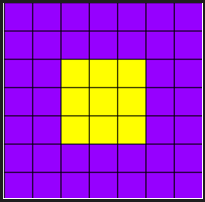
Para un ordenador una imagen es un array de pixel values.

(representación 7x7 de un cuadrado)

(pixel values)

image generation pixel values

(pixel representation)

image generation pixel representation

Filtros

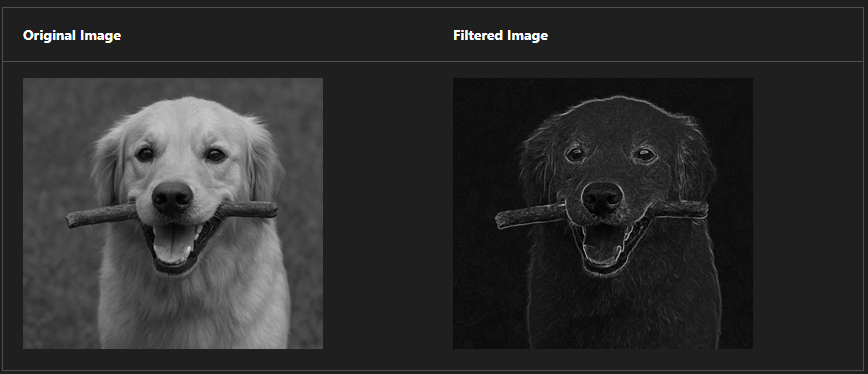
Una manera de procesar una imagen es aplicar filtros que modifiquen los pixel values de esa imagen para crear un efecto visual. Un filtro se define por uno o más filter kernels (arrays de pixel values)

ejemplo de filter kernel 3x3

filter kernel

este filter kernel de 3x3 se irá ejecutando a lo largo de toda la imagen para obtener el resultado final

filter kernel processing

Si los valores se salen de la escala 0-255, estos se ajustan para que encajen de nuevo.

Este tipo de filtros se llaman convolutional filtering. Ejemplo de este tipo de filtros aplicado:

filter kernel result

Read More

Computer vision

Computer vision se centra en permitir a las aplicaciones de IA ser capaces de procesar información visual.

El término computer vision es una aglomeración de tareas y técnicas donde la IA procesa input visual, típicamente de imágenes, vídeos o live streams.

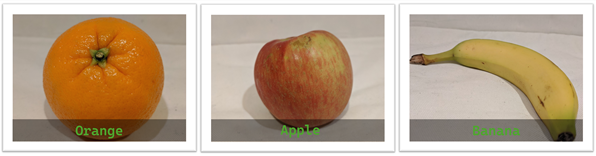
Clasificación de imágenes

Una de las ramas más antiguas. Un modelo es entrenado con un set de imágenes realmente grande para poder predecir una text label a partir de una imagen.

image classification example

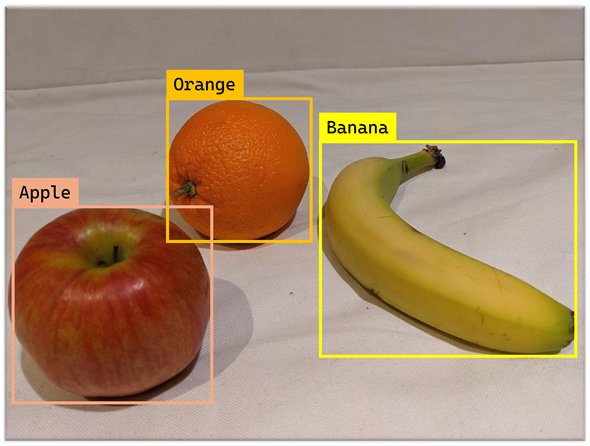
Detección de objetos

Examina multiples regiones de una imagen para encontrar objetos individuales y su posición en la imagen. Indica las coordenadas del objeto mediante un box rectangular.

object detection example

Segmentación semántica

Una técnica más sofisticada. Un modelo es estrenado para encontrar objetos y marcar sus píxeles individuales en la imagen.

semantic segmentation example

Read More

Speech synthesis (text-to-speech)

Pipeline de generación de audio

Cuando pides que se sintetice la siguiente frase

Dr. Chen’s appointment is at 3:00 PM

  1. Text normalization: lo convierte a Doctor Chen’s appointment is at three o’clock P M
  2. Análisis linguístico: lo convierte a fonemas /ˈdɑktər ˈtʃɛnz əˈpɔɪntmənt ɪz æt θri əˈklɑk pi ɛm/
  3. Generación de prosodia: detecta que hace falta subir un poco el tono para hacer énfasis en appointment, una pausa después de is y hacer enfasis de nuevo en three
  4. Speech synthesis: genera las ondas de audio para esas especificaciones

Normalización de texto

Preparar el texto para ser leido incluyendo números, símbolos etc

Dr. Smith ordered 3 items for $25.5

lo convierte a

Doctor Smith ordered three items for twenty-five dollars and fifty cents

Análisis linguístico: de texto a fonemas

  1. convertimos de segmentos de texto a sílabas y palabras
  2. mirar la pronunciación en lexicons (pronunciation dictionaries)
  3. aplicar reglas G2P o neural models a palabras no reconocidas
  4. marcar silabas e identificar las tónicas
  5. determinar contexto fonético

Read More

Speech recognition (speech-to-text)

How all works together

  1. Audio capture: captura la señal en raw
  2. Pre-processing: extraer MFCC features that highlight speech patterns
  3. Accoustic modeling: predict phoneme probabilities using transformer networks
  4. Language modeling: apply vocabulary and grammar knowledge
  5. Decoding: search for best word sequence
  6. Post-processing: format the text for human readers

Permite a las aplicaciones convertir idioma hablado en texto escrito.

Captura de audio: convertir audio análogo en digital

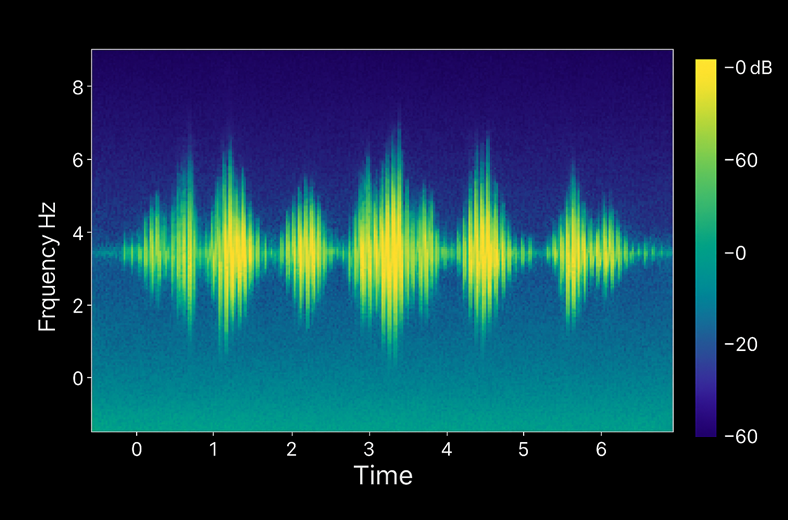
Se comienza convirtiendo las señales de audio en una señal digital. Se samplea el audio miles de veces por segundo - 16 kHz = 16,000 veces por segundo - y se guarda cada valor individual.

Ratios más altos (44 kHz para música) capturan más detalle pero requieren más procesamiento.

Para reconocimiento del habla se balancea entre 8 kHz y 16 kHz

En este paso se limpia la señal y se quita ruido de fondo.

speech recognition raw

Pre-procesamiento: extraer meaningful features

El audio en crudo (raw) contiene demasiada información. Se hace un preprocesamiento para compactar la señal y retirar detalles irrelevantes

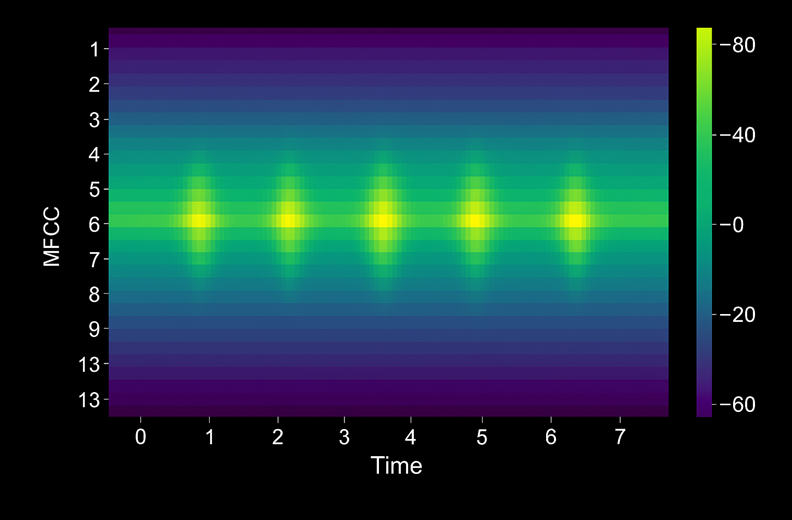
Mel-Frequency Cepstral Coefficients (MFCCs)

MFCC es la técnica más común para speech recognirition. Trabaja de forma parecida a como nuestros oídos escuchan el sonido - haciendo enfasis en las frecuencias donde se concentra la energia y comprimiendo las menos importantes

Como funciona MFCC:

  1. Divide el audio en frames: con un overlapping de 20-30 ms
  2. Aplica la transformada de Fourier: convierte cada frame de tiempo a frecuencia
  3. Mapea en la escala Mel: Ajusta frecuencias para adaptarlas al oído humano
  4. Extrae coeficientes: Computa un muestreo (13 coeficientes) que hace un resumen de forma espectral de cada frame

El resultado es una secuencia de vectores (uno por frame) que captura el sonido del audio sin tener que guardar cada sample.

speech recognition MFCC

Estos vectores son el input para Acoustinc modeling

Frame Vector (13 coeficientes)
Frame 1 [-113.2, 45.3, 12.1]
Frame 2 [-112.8, 44.7, 11.8]
… …

Read More

AI Speech concepts

Speech recognition convierte palabras habladas en texto, mientras que speech synthesis convierte texto en audio. Juntas permiten operar como manos-libres y mejoran la accesibilidad.

Speech-enabled solutions

Esto te puede ayudar a:

  • Accesibility: ayuda a usuarios con problemas visuales.
  • Productivity: permitir multitasking al quitar teclados y pantallas.
  • Mejorar UX al crear conversaciones naturales.
  • Audiencias globales al soportar multiples idiomas.

Speech-synthesis scenarios (text-to-speech)

Algunos ejemplos de casos de uso:

  • IA y chatbots conversacionales
  • Accesibilidad

Combine speech recognition and synthesis

Ejemplos:

  • Customer service: entender y responder al usuario
  • Aprendizaje de idiomas

Factores a tener en cuenta

  • calidad de audio: background noise, micro and network quality
  • idiomas soportados
  • privacidad: entender como se procesa y se guarda el audio
  • latencia: poder hablar y reconocer audio requiere low-latency
  • accesibilidad

Read More

Represent text as vectors

Pasando por un modelo de embedding podemos convertir texto en vectores. Estos vectores representan puntos en un espacio inter-dimensional, definido por coordenadas en ejes.

Cada vector describe una dirección y una distancia desde el punto de origen. Pongamos el siguiente ejemplo:

Word Vector
dog [0.8, 0.6, 0.1]
puppy [0.9, 0.7, 0.4]
cat [0.7, 0.5, 0.2]
kitten [0.8, 0.6, 0.5]
young [0.1, 0.1, 0.3]
ball [0.3, 0.9, 0.1]
tree [0.2, 0.1, 0.9]

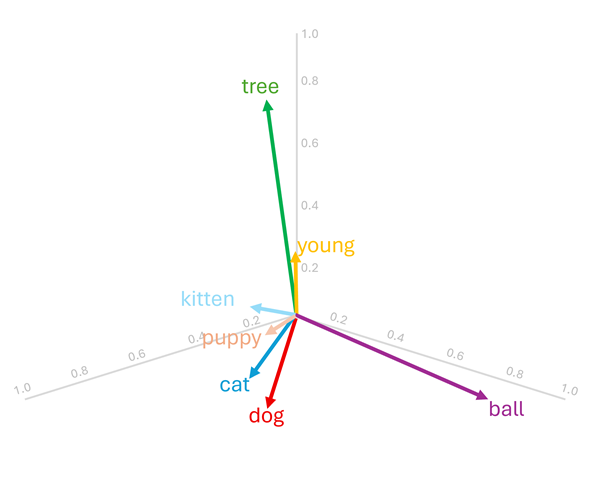
Podemos visualizar estos vectores en un espacio de 3 dimensiones:

vectores 1

Podemos ver que los vectores de palabras semánticamente similares, son próximos unos a otros (dog, cat, puppy, kitten). Como las características intrínsecas de las palabras están encodeadas es las mismas, es posible ejecutar operaciones para comparar palabras y hacer análisis sobre ellas.

Encontrar términos relacionados

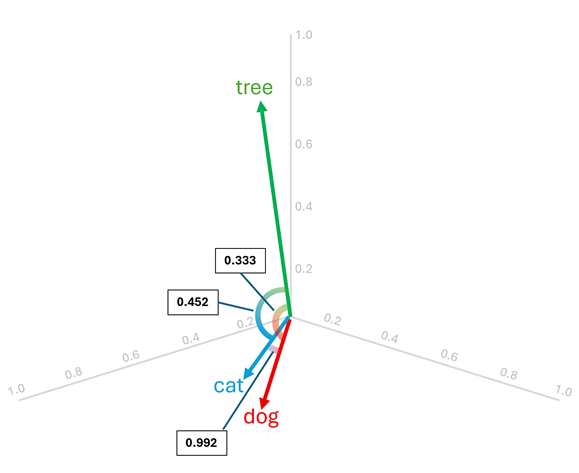
Como conocemos la dirección y la distancia de los vectores, y palabras similares tienden a tener orientaciones similares, podemos hacer cálculos como cosine similarity entre vectores, para hacer comparaciones.

En este caso podemos ver que la cosine similarity entre cat y dog (0.992) es mayor que con tree (0.333) y (0.452).

vectores cosine similarity

Vector translation (addition; substraction)

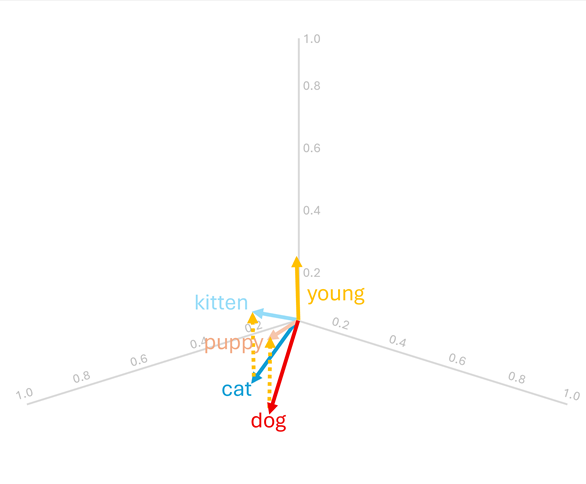
Como lo que tenemos es texto en forma de vectores, y estos vectores se pueden sumar y restar entre ellos, podemos aplicar operaciones básicas para transformar vectores.

En este ejemplo podemos ver que:

  • dog [0.8, 0.6, 0.1] + young [0.1, 0.1, 0.3] = puppy [0.9, 0.7, 0.4]
  • cat [0.7, 0.5, 0.2] + young [0.1, 0.1, 0.3] = kitten [0.8, 0.6, 0.5]

vectores translation

por lo general esto no produce resultados exactos, si no que hay que buscar el vector más próximo al resultado que hemos obtenido

podríamos hacer lo mismo con una resta (puppy - young = dog)

Razonamiento analógico

La aritmética de vectores puede responder preguntas como:

puppy es a dog, lo que kitten es a ?

Para resolver esto hacemos

kitten - puppy + dog = cat

Read More

NLP concepts

NLP es Natural Language Processing
NLU es Natural Language Understanding

Partimos de la base que tenemos un texto ya partido en tokens

  • We
  • choose
  • to
  • go
  • to
  • the
  • moon

    Técnicas Pre-procesamiento

Antes de hacer ningún tipo de procesamiento de lenguaje, pre-procesamos los tokens en función de lo que queramos conseguir

Técnica Descripción
Text normalization Antes de generar el token podemos querer normalizar el texto en función de nuestro análisis (quitar signos puntuación, todo a minúsculas). Esto puede ayudar para análisis de frecuencia de palabras pero perdemos significado semántico.

Mr Banks has worked in many banks. quizás queramos diferenciar entre la persona y el banco, o entre banks. y banks. Ese punto añade información de que la frase termina
Stop word removal Stop words son palabras que se deben excluir del análisis ya que no aportan nada. Por ejemplo the, a, it
N-gram extraction Encontrar frases que se puedan representar de diferentes maneras: artificial intelligence o natural language processing.
Una frase con una palabra es un unigram, con dos palabras es bigram, con tres trigram
Stemming Técnica para consolidar palabras quedándote solo con la raíz: si de las siguientes palabras powering, powered, powerful quitamos las terminaciones ing, ed, ful nos queda el mismo token power
Lemmatization Otra forma de reducir palabras a su forma base (llamada lemma). A diferencia de stemming no acorta las palabras si no que se basa en linguistica y vocabulario para asegurarse que el resultado es válido. Ejemplo running -> run o global -> globe
Parts of speech (POS) tagging Poner labels a cada token con su categoría gramatical (noun, verb, adjective or adverb). Tiene en cuenta el token y su contexto en la frase

Statistical text analisis

Una vez tenemos ya hecho el pre-procesamiento y los tokens, podemos hacer análisis sobre documentos

Frequency Analysis

La forma más obvia en analizar un único documento aislado. Consiste en contar el número de veces que aparece un token en un documento.

Term Frequency
ai 4
business 3
benefit 2

Read More

Prompts & Agents

Un prompt es un input a un LLM para generar una respuesta.

Tipos de prompt

System prompt: indica el comportamiento y tono del modelo, y cualquier limitación a la que se tenga que adherir el sistema

You’re a helpful assistant that responds in a cheerful, friendly manner

User prompt: piden una respuesta a una pregunta o instrucción específica

Summarize the considerations for …

Normalmente, el prompt de sistema lo establece la aplicación que usa el modelo y los prompts de usuario son los que introduce el humano (o la aplicación en nombre del humano)

Historial de conversación

Los LLMs no tienen memoria. Cada vez que mandamos un nuevo mensaje en realidad se está mandando todo el historial de mensajes hasta la fecha, o una versión resumida de este.

Tips para mejores prompts

  • Be clear and specific: prompts con instrucciones o preguntas explícitas funcionan mejor que lenguaje vago
  • Add context: menciona el tema, audiencia o formato que quieres
  • Use examples: si quieres cierto estilo determinado, añade ejemplos con lo que quieres
  • Ask for structure: como bullet points, tablas o listas

Agentes

Los agentes de IA son aplicaciones construidas sobre IA generativa que pueden razonar y generar mediante lenguaje natural, automatizar tareas usando herramientas y responder a condiciones contextuales para tomar las acciones apropiadas.

Se componen de:

  • Un LLM: es el cerebro del agente
  • System prompt: prompt de sistema que define el rol del agente y su comportamiento
  • Tools: las usa el agente para interactuar con su entorno. Se dividen en:
    • Knowledge tools: proveen de acceso a información (search engines, DDBB)
    • Action tools: permiten al agente ejecutar tareas (enviar emails, actualizar un calendario)

Los agentes también pueden trabajar unos con otros formando sistemas multi-agénticos. En vez de tener un único agente que haga todo, podemos tener multiples agentes que colabores, aportando cada uno su especialidad

  • Agente 1: recopila datos
  • Agente 2: los analiza
  • Agente 3: decide el mejor curso
  • Agente 4: emprende la acción decidida

Read More

How gen AI works under the hood

Los LLMs se entrenan para generar una respuesta en base a un prompt. Usan relaciones semánticas para entender las relaciones entre palabras (en lenguaje natural) y generar una respuesta relevante.

Teniendo el siguiente ejemplo, saben identificar las palabras más importantes y la posición contextual en la frase.

I heard a dog bark loudly at a cat

Tokenization

El primer paso es partir el input en tokens

  • I (1)
  • heard (2)
  • a (3)
  • dog (4)
  • bark (5)
  • loudly (6)
  • at (7)
  • a (3) already assigned
  • cat (8)

Vectores iniciales y encoding posicional

Inicialmente los vectores de los tokens se asignan de manera aleatorio, antes de ser alimentados al transformer para crear embeddings. Aparte de estos vectores aleatorios también se envía la posición del token en la secuencia, ya que es determinante para indicar su importancia.

recordar que los vectores aquí son aleatorios antes de que los procese el transformer

Token Token ID Position Vector
I 1 1 [3,7,10]
heard 2 2 [2,15,1]
a 3 3 [9,11,1]
dog 4 4 [2,7,11]
bark 5 5 [9,12,0]
loudly 6 6 [3,8,13]
at 7 7 [5,7,10]
a 3 8 [9,11,1]
cat 8 9 [8-6,9]

Transforming tokens with a transformer

Ahora que tenemos los tokens con un ID, necesitamos relacionarlos entre ellos. Esto se hace asignándoles vectores los cuales contienen el valor semántico del token (llamados embeddings)

[0.12, -0,85, …, 0.42]

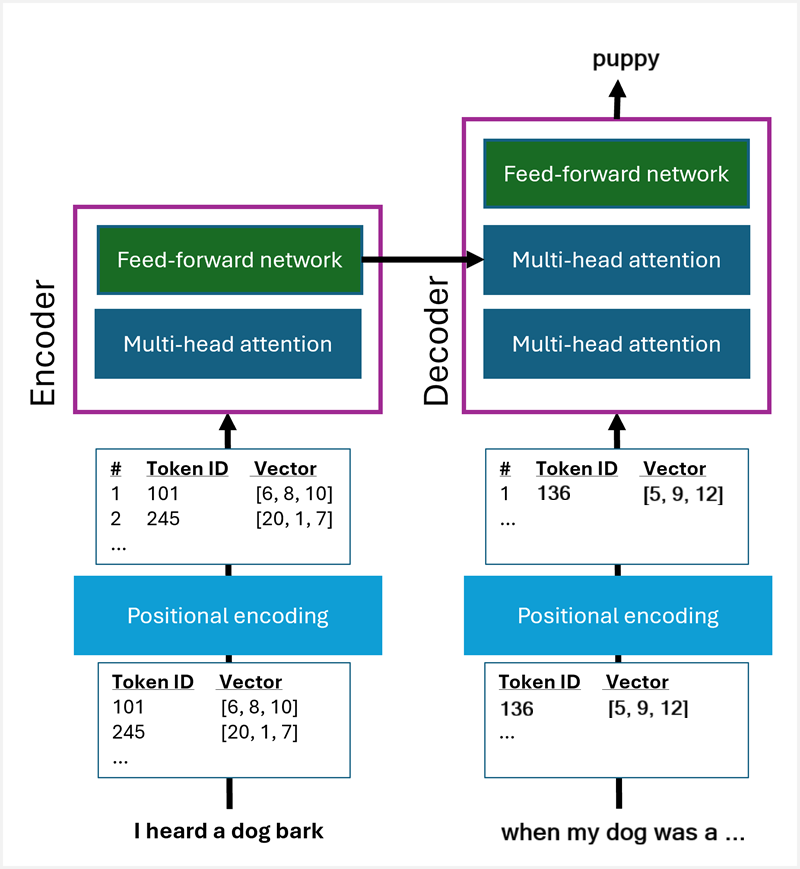
Esto se hace mediante un transformer model, el cual consiste de 2 bloques:

  • encoder block: crea los embeddings aplicando una técnica de attention. La attention layer examina cada token por turnos y determina cuánto se ve influenciado ese token por los que están a su alrededor. Para hacer este proceso de manera más eficiente se usa una multi-head attention para examinar tokens de manera paralela y asignarles weights que se usan para calcular los vectores. Los resultados de la attention layer se procesar por una red neuronal para encontrar los vectores que mejor representan al embedding.
  • decoder layer: usa los embeddings calculados por el encoder para determinar el próximo token más probable en una secuencia comenzada por un prompt. El decoder también consiste de una attention layer y una red neuronal para hacer sus predicciones

transformer block

Read More

Microsoft Responsible AI principles

Muy importantes para el examen, muy sin más para la vida

Principle Description
Equidad Los sistemas de IA deben tratar a todos las personas de forma equitativa. Los datos pueden reflejar bias que haga a los modelos discriminatorios.

Los desarrolladores de sistemas de IA tienen que minimizar ese bias y comprobar que los sistemas sean equitativos.
Confiabilidad La IA se basa en modelos probabilísticos que no son infalibles. Las aplicaciones de IA necesitan mitigar los riesgos de manera acorde.
Privacidad y seguridad Los modelos se entrenan usando datos, los cuales pueden incluir información personal. Los desarrolladores de sistemas de IA deben asegurar que los datos de entreno son seguros, privados y que los modelos mismos no pueden revelar información privada (PII/PHI) o organizacional.
Inclusión Los sistemas de IA deben estar abiertos para todo el mundo. Los desarrolladores de IA deben asegurar que no se excluyen a algunos usuarios.
Transparencia Hacer los sistemas comprensibles a los usuarios y sus limitaciones potenciales.
Responsabilidad Las personas y compañías que distribuyen sistemas de IA deben ser responsables de sus acciones.
Deben definir y aplicar frameworks de gobernanza.

Read More