Posts Tagged - genAI

AI-200: Azure AI Cloud Developer Associate

status: in progress

(los posts aquí contenidos han sido creados (y contienen imágenes oficiales) siguiendo los cursos oficiales self-paced de learn.microsoft.com AI-200. Para más información recomiendo seguir los mismos cursos)

Contents

Develop containerized solutions on Azure (20-25%)

  • Implement container application hosting
  • Implement container-orchestrated solutions

Develop AI solutions by using Azure data management services (25-30%)

  • Develop AI solutions by using Azure Cosmos DB for NoSQL
  • Develop AI solutions by using Azure Database for PostgreSQL
  • Integrate Azure Managed Redis in AI solutions

Connect to and consume Azure services (20-25%)

  • Develop event- and message-based AI solutions
  • Develop and implement Azure Functions

Secure, monitor, and troubleshoot Azure solutions (20-25%)

  • Implement secure Azure solutions
  • Monitor and troubleshoot Azure solutions

Microsoft official learning paths

Azure Container Registry (ACR)

Azure Container Registry es un registro privado para almacenar y distribuir contenedores y artefactos, que posteriormente pueden ser desplegados por otros servicios de Azure.

(store and manage container images in Azure Container Registry)

Azure Container Registry (ACR)
Build and run images (ACR Tasks)
Images’ versions and tags
ACR CLI


Azure App Service

Azure App Service es una plataforma para alojar webapps y APIs. Permite desplegarlas mediante contenedores (o directamente subir source code)

(deploy container images to Azure App Service)

Azure App Service
Configure container runtime
Configure app settings
Troubleshoot container apps
Azure App Service CLI

(run sidecar pattern on Azure App Service)

Sidecar pattern
Configure main and sidecar containers
Connect containers and share files
(TODO) Diagnose sidecar failures


Azure Container Apps (ACA)

Azure Container Apps permite ejecutar microservicios y jobs basados en contenedores sin tener que gestionar un clúster de K8s ni su infra subyacente

Azure Container Apps commands can require the Container Apps extension. Run az extension add --name containerapp --upgrade. Add --allow-preview true if you need such features

az login
az upgrade
az extension add --name containerapp --upgrade

az provider register --namespace Microsoft.App
az provider register --namespace Microsoft.OperationalInsights

(deploy containers to Azure Container Apps)

Environments
Deployments (CLI & YAML)
Runtime (env vars & secrets)
Pull from private registries
Verify deployments (logs & status)

(manage containers in Azure Container Apps)

Update Images (& manage revisions)
Manage container app lifecycle
Monitor logs
Health probes
Optimizar recursos de contenedor y scaling

(scale containers in Azure Container Apps)

Configure scale rules
Event-driven scaling with KEDA
KEDA scalers for custom workloads
Select resources for performance and cost
Revision modes

(run AI-generated code securely in ACA dynamic sessions)

Las aplicaciones de IA generan código para analizar datos, ejecutar cálculos o crear ficheros. Azure Container Apps dynamic sessions ofrece entornos de ejecución aislados y environments efímeros para ejecutar ese código no confiable, sin exponer la aplicación de IA ni el host

Choose dynamic session pool
Configure a secure session pool
Execute code and exchange files
Manage lifecycle and execution failures


Azure Kubernetes Service (AKS)

Azure Kubernetes Service es el servicio administrado de Kubernetes de Azure. Permite crear y operar clústeres de K8s en Azure para desplegar y gestionar aplicaciones basadas en contenedores

(deploy applications to Azure Kubernetes Service)

Create K8s deployment manifest
Como exponer apps
Deploy apps to Azure Kubernete Service

(configure applications on Azure Kubernetes Service)

Define ConfigMaps
Define Secrets
Attach persistent storage to an app

(monitor and troubleshoot applications on Azure Kubernetes Service)

Monitor app logs and metrics


Azure Cosmos DB for NoSQL

Azure Cosmos DB for NoSQL es una BBDD NoSQL distribuida y administrada por Azure, orientada al almacenamiento de documentos JSON. Permite trabajar con estructuras de datos flexibles sin definir un schema rígido. Está diseñada para baja latencia, escalabilidad horizontal y distribución geográfica

Se puede usar como BBDD vectorial

(build and query with Azure Cosmos DB for NoSQL)

Azure CosmosDB for NoSQL
Implement SDK
Queries in CosmosDB

(implement vector search with Azure Cosmos DB for NoSQL)

Store and retrieve embeddings
Vector semantic search
Combine vector similarity results with metadata filtering
Use change feed to trigger embedding refresh

(optimize queries for Azure Cosmos DB for NoSQL)

Understand Indexes
Configure range and composite indexes
Tune vector indexes for embedding workloads
Reduce RU costs with strategic indexing
(TODO) Choose consistency levels for optimal performance


Azure Database for PostgreSQL

Azure Database for PostgreSQL es un servicio de BBDD relacionales administrado por Azure. Permite usar PostgreSQL sin gestionar la infra subyacente. Azure se encarga de backups, updates y escalado

PgBouncer es una herramienta con un pool de conexión que reduce el overhead de crear conexiones constantemente, manteniendo una pool de conexiones reusables a través de las cuales enruta a los clientes. Esto reduce el overhead para apps que usan short-lived connections. Usa otro puerto (6432)

pgvector es una extensión que añade vector data types y similarity search operators a PostgreSQL. Antes de poder usar embeddings, hay que activar pgvector en la BBDD

(build and query with Azure Database for PostgreSQL)

Azure Database for PostgreSQL
Connect to PostgreSQL
Create and manage schemas
Query data
Integrate SDKs and Apps

(implement vector search with Azure Database for PostgreSQL)

pgvector - store and query embeddings
Fast vector similarity search
Manage index lifecycle and embedding updates
Run vector similarity search for semantic retrieval
(TODO) Implement retrieval patterns for RAG pipelines

(optimize vector search in Azure Database for PostgreSQL)

Tune PostgreSQL for pgvector
Choose and configure vector indexes
Optimize data layout
(TODO) Connection Optimization


Azure Managed Redis

Azure Managed Redis (puerto 10.000) es un almacén de datos en memoria diseñado para ofrecer muy baja latencia y alto rendimiento. Su uso más habitual es como caché de datos entre la app y su almacenamiento principal, aunque también se puede usar para comunicar micros en tiempo real (pub/sub y Streams), o también se puede usar como BBDD vectorial en memoria

Azure Cache for Redis (sistema viejo; puerto 6380) servicio administrado clásico de Redis en Azure, usado principalmente como caché distribuida, almacenamiento de sesiones o mensajería Pub/Sub. Está siendo desfasado por Azure Manage Redis

Redis pub/sub está diseñado para hacer broadcasting de eventos a múltiples consumidores de manera simultánea. Permite a los publishers hacer broadcast de mensajes a través de channels y a los subscribers subscribirse a estos channels para recibir mensajes. Cuando subscribes multiples servicios al mismo pub/sub channel, cada subscriber recibe cada mensaje - los mensajes se duplican. No hay garantías de entrega, puede que el mensaje llegue a todos los consumidores o puede que no llegue a ninguno

Redis Streams está diseñado para coordinar múltiples subscribers a través de consumer groups. Estos groups aseguran que cada mensaje se entregue automáticamente a un único subscriber, lo que permite un escalado horizontal sin cambiar el código. Están preparados para manejar fallos y retries

(data operations)

Azure Managed Redis
Implement data ops

(event messaging)

Redis pub/sub
Task queues (Redis Streams)
Broadcast (pub/sub) vs Coordinated distribution (Redis Streams)

(vector storage)

Index and query vector data
Choose vector types and indexing strategies
Optimize data structures for vector storage


Azure Service Bus

Azure Service Bus es un servicio de mensajería async administrado por Azure. Está diseñado para comunicar apps y micros de forma desacoplada y fiable. Se basa en queues (punto a punto) y/o topics + subscriptions (pub/sub)

(queue and process AI operations)

Azure Service Bus
Queues vs topics & subscriptions
Structure messages
Process messages reliably


Azure Event Grid

Azure Event Grid es un servicio fully managed que conecta productores y consumidores de eventos, de forma desacoplada. Event Grid está preparado para manejar millones de eventos / s con una latencia mínima (<1s)

Opera como un servicio pub-sub que enruta eventos de productores a consumidores sin tener que administrar nosotros la infraestructura. El servicio ingesta eventos de otros servicios Azure, custom apps y/o partner systems y o bien entrega esos eventos a los endpoints de los consumidores, basándose en subscription filters, o son los mismos consumidores los que hacen pull de los eventos para leer a su ritmo.

(develop event-driven AI workflows)

Azure Event Grid
Event schemas and properties
Configure delivery and retry policies
Publish custom events


Azure Functions

Azure Functions es un servicio serverless para ejecutar código bajo demanda sin tener que administrar servidores. Pueden escalar de manera automática según la carga y soportan diferentes tipos de triggers y bindings

Están pensadas para ejecutar tareas ligeras, independientes y que no mantengan estado entre ejecuciones

Azure Functions Set up local dev environment
Create triggers and bindings
Manage secrets and configurations
Configurar identity y access


Azure Durable Functions

Azure Durable Functions es una extensión de Azure Functions diseñada para procesos serverless, con estado y de larga duración.

Están pensadas para ejecutar procesos de varios pasos, cadenas o esperas largas o procesos que requieren de intervención humana

Graban cada operación y permiten hacer un replay para reconstruir el estado local que teníamos. Permiten que un workflow sobreviva a reinicios del host

Azure Durable Functions
Process independent work with fan-out/fan-in
Coordinate human approval with external events
Design reliable workflow steps


Azure Web PubSub

Azure Web PubSub es un servicio completamente administrado para comunicación en tiempo real. Sus casos de uso típicos son chats y notificaciones en tiempo real, juegos multijugador y streaming de tokens de IA/LLMs hacia el frontal. Se usa cuando el server necesita enviar información al cliente sin esperar a que este haga otra petición HTTP

// TODO: Lo dejo para más adelante. La doc oficial es muy MUY densa y es demasiado para mi ahora mismo. Está en Integrate backend services for AI Solutions > último módulo

Azure Web PubSub


Azure Key Vault

Azure Key Vault es un servicio administrado para centralizar, almacenar y proteger secretos, contraseñas, claves criptográficas y certificados, evitando hardcodearlos en código, repos o archivos de config

Permite que las apps de Azure accedan de forma controlada a estos valores mediante Entra ID y Managed Identities (RBAC)

Store and organize secrets, keys and certificates
Retrieve secrets using Azure SDK client libraries
Handle secret versioning and rotation
Implement caching strategies


Azure App Configuration

Azure App Configuration es un servicio administrado, que almacena app settings en pares clave-valor, de forma centralizada en el cloud. Permite modificar configuración dinámicamente y gestionar feature flags, hacer despliegues progresivos o experimentar sin tener que desplegar la app de nuevo

Nos evita tener que repartir params y settings entre múltiples servicios, archivos o despliegues

Azure App Configuration
Organize settings with labels and feature flags
Reference Key Vault secrets
App Configuration vs Key Vault (what to store)


OpenTelemetry

OpenTelemetry es un framework de observabilidad vendor-neutral, open-source. Provee de un set unificado de APIs, SDKs, herramientas para generar, recolectar y exportar telemetría

OpenTelemetry
Add OpenTelemetry SDK
Configure spans and traces
Export telemetry to Azure Monitor
Debug distributed flows with trace data


Azure Monitor

Azure Monitor es la plataforma central de observabilidad y monitorización central de Azure. Está diseñada para recopilar, analizar y visualizar métricas, logs y telemetría de apps e infra.

Permite conocer el estado y rendimiento de recursos, consultar logs, crear dashboards y alertas y detectar problemas antes de que afecten al usuario

Kusto Query Language (KQL) es la primary tool que se usa para hacer retrieve y analizar log data almacenada en Azure Monitor, Log Analytics, y Azure Data Explorer

Kusto Query Language (KQL)
Explore logs
Build Dashboards for App telemetry Set alerts for app failures and anomalies


Azure Insights

// TODO: add desc


Official Labs

Official labs (in python)

AI-901: Microsoft Azure AI Fundamentals

Microsoft Certified: Azure AI Fundamentals

badge microsoft fundamentals AI-901

(los posts aquí contenidos han sido creados, y contienen imágenes oficiales, siguiendo los cursos oficiales self-paced de learn.microsoft.com AI-901. Para más información recomiendo seguir los mismos cursos)

Contents

Identify AI Concepts and capabilities (40-45%)

  • Describe principles of responsible AI (fairness, reliability, privacy, transparency, accountability)
  • Identify AI model components and configurations
  • Identify AI workloads

Implement AI solutions by using Microsoft Foundry (55-60%)

  • Implement generative AI apps and agents by using Foundry
  • Implement AI solutions for text and speech
  • Implement AI solutions with computer vision and image generation
  • Implement AI solutions for information extraction

Microsoft official learning paths

AI concepts for developers and technology professionals

Microsoft responsible principles

AI

How gen AI works under the hood
Representar texto como vectores
RAG concepts
Prompts & agents

NLP

NLP concepts (techniques)

Information extraction

AI concepts extraction (OCR)

Speech concepts

Speech concepts
Speech recognition (speech-to-text)
Speech synthesis (text-to-speech)

Computer vision

Computer vision
Image processing
Vision transformers & Multimodal models

Get started with AI applications and agents on Azure Foundry

Azure

Understand Azure

AI in Microsoft Foundry

Microsoft Foundry for AI
genAI models in Foundry
Agents in Foundry

Microsoft Foundry by area

Text analysis in Foundry
Speech in Foundry
Computer vision in Foundry
Information extraction with AI (Azure Content Understanding)
Managed Knowledge Layer (Microsoft Foundry IQ)

Labs

Official labs (in python)

AI Index

ML Engineering

NLP (Natural Language Processing)

AI Engineering

Base knowledge

AI Base Concepts (LLM, Context Window, Transformer, Attention Layer, Self-attention)
Embeddings & Vectors (Vector DDBB, Vector search vs BM25)
How LLMs generate the next token (Sampling, Logits, Softmax layer, logprobs)
LLM Hyperparameters (temperature, top_p, top_k)
Data Grounding (RAG; fine-tuning)
Chunking (static vs semantic)

Protocols

MCP (Model Context Protocol), Skills & Instructions

Security

AI Attack Vectors

Prompt Engineering

Prompting Techniques
(my own) Prompt Templates

Hands-on

RAG hands-on implementation (with code)

Frameworks

LangChain
MAF (Microsoft Agent Framework)

IDEs

Github Copilot (Visual Studio)

Interact with Github Copilot
Advanced Copilot Features

Cursor

Cursor (IDE con IA integrada)

Claude

Claude (Code & Cowork)

Ollama & local LLMs

Ollama and OpenWeb UI

Legislation

AI EU Legistlation

RAG concepts

RAG (Retrieval Augmented Generation) es una técnica que complementa el prompt con información de diferentes fuentes de conocimiento externas, como documentos o emails, para aumentar el prompt con datos relevantes y basar la respuesta en esas fuentes.

La respuesta del modelo se basará en la información proveída (data grounding) y sirve para suplir carencias en los datos de entrenamiento de los modelos o para complementarlos con datos propietarios.

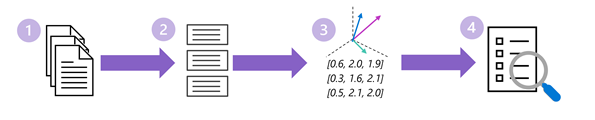
Index data

La búsqueda solo puede encontrar la información que previamente se ha indexado. Antes de que el RAG pueda responder preguntas, necesita una indexing pipeline que prepare los datos

RAG indexing

  1. Select source data
  2. Hacer chunking
  3. Hacer encoding de text tokens a embeddings
  4. Crear un index donde se puedan buscar estos embeddings

Select and process source data

Limpiar y procesar todos los documentos de entrada

  1. Cargar contenido de sus fuentes
  2. Extraer texto útil y estructurarlo
  3. Limpiar el contenido (remover headers repetidos, navigation text, etc )
  4. Añadir metadatos (título, source URL, categoría, etc)

Read More

AI concepts extraction

Esto se utiliza para extraer datos estructuradas desde media no estructurada como documentos, imágenes, audio o vídeo.

Optical Character Recognition (OCR)

Tecnología que convierte formatos visuales en texto.

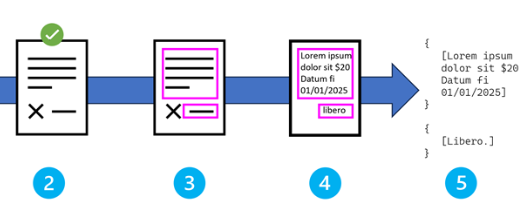
OCR flow

  1. Preprocesamiento y mejoras de la imagen
  2. Detección de zonas de texto
  3. Character recognition and classification
  4. Output generation and post processing

Preprocesamiento e image enhancement

Antes de comenzar con la detección de texto se aplican técnicas para optimizar y mejorar la imagen

  • Noise reduction: remueve artefactos visuales, polvo o imperfecciones.
  • Contrast adjustment: mejora el contraste entre texto y fondo
  • Correción de desvíos (horizonte): alinea la rotación del documento
  • Resolution optimization

Text region detection

El sistema identifica las áreas que contienen texto usando las siguientes técnicas

  • Layout analysis: distingue entre zonas de texto, imágenes o gráficos y zonas en blanco
  • Text block identification: agrupa caracteres en palabras, lineas y parrafos
  • Reading order determination: de izq a derecha, top to bottom o viceversa
  • Region classification: identifica headers, body text, tables

Read More

Vision transformers & Multimodal models

Semantic model for images - Vision transformers

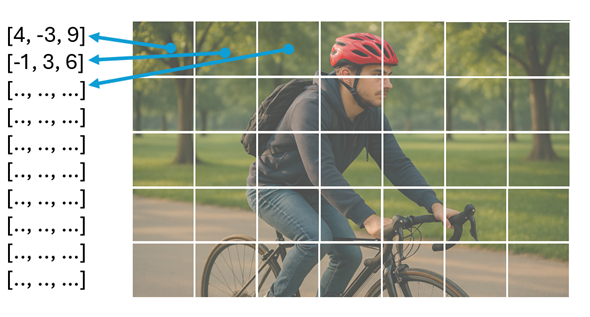
The same way we have transformers for embeddings to hold semantic meaning, we use vision transformer models, in which a model is trained using large volume of images. Instead of encoding text-based tokens, the transformer extracts patches of pixel values from the image, and generates a linear vector from the pixel values.

vision transformer

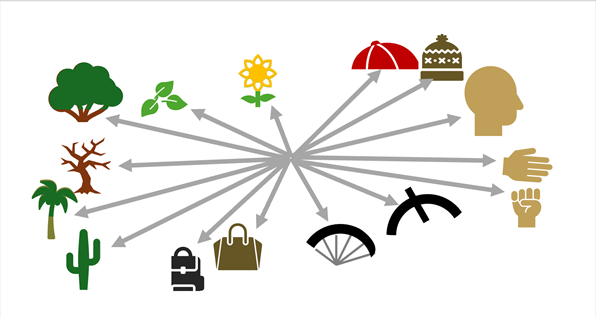
La misma técnica de attention que se usa en LLMs para los embeddings de relacionar contenido semántico, se usa aquí para relacionar los patches según diferentes características visuales como color, forma, contraste, textura, etc.

visual_embeddings

Los embeddings son embeddings, da igual si se crearon a partir de texto o de imágenes. Son vectores donde contenido relacionado tendrán direcciones similares.

Read More

Speech synthesis (text-to-speech)

Pipeline de generación de audio

Cuando pides que se sintetice la siguiente frase

Dr. Chen’s appointment is at 3:00 PM

  1. Text normalization: lo convierte a Doctor Chen’s appointment is at three o’clock P M
  2. Análisis linguístico: lo convierte a fonemas /ˈdɑktər ˈtʃɛnz əˈpɔɪntmənt ɪz æt θri əˈklɑk pi ɛm/
  3. Generación de prosodia: detecta que hace falta subir un poco el tono para hacer énfasis en appointment, una pausa después de is y hacer enfasis de nuevo en three
  4. Speech synthesis: genera las ondas de audio para esas especificaciones

Normalización de texto

Preparar el texto para ser leido incluyendo números, símbolos etc

Dr. Smith ordered 3 items for $25.5

lo convierte a

Doctor Smith ordered three items for twenty-five dollars and fifty cents

Análisis linguístico: de texto a fonemas

  1. convertimos de segmentos de texto a sílabas y palabras
  2. mirar la pronunciación en lexicons (pronunciation dictionaries)
  3. aplicar reglas G2P o neural models a palabras no reconocidas
  4. marcar silabas e identificar las tónicas
  5. determinar contexto fonético

Read More

Speech recognition (speech-to-text)

How all works together

  1. Audio capture: captura la señal en raw
  2. Pre-processing: extraer MFCC features that highlight speech patterns
  3. Accoustic modeling: predict phoneme probabilities using transformer networks
  4. Language modeling: apply vocabulary and grammar knowledge
  5. Decoding: search for best word sequence
  6. Post-processing: format the text for human readers

Permite a las aplicaciones convertir idioma hablado en texto escrito.

Captura de audio: convertir audio análogo en digital

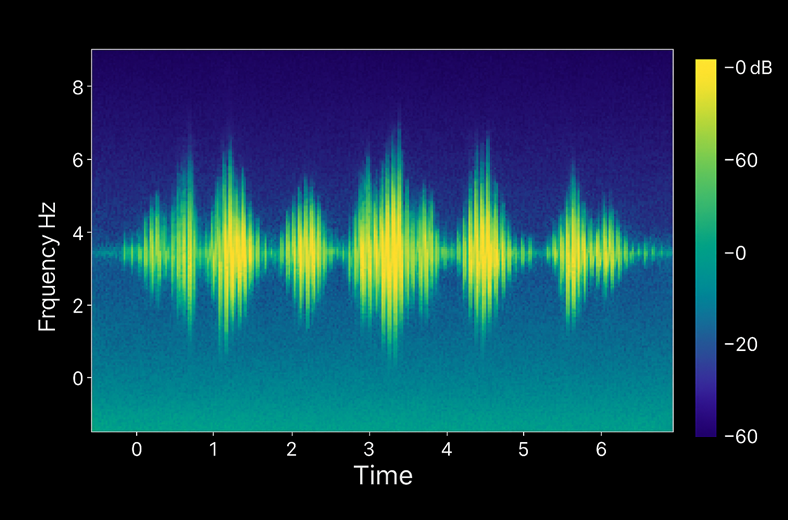
Se comienza convirtiendo las señales de audio en una señal digital. Se samplea el audio miles de veces por segundo - 16 kHz = 16,000 veces por segundo - y se guarda cada valor individual.

Ratios más altos (44 kHz para música) capturan más detalle pero requieren más procesamiento.

Para reconocimiento del habla se balancea entre 8 kHz y 16 kHz

En este paso se limpia la señal y se quita ruido de fondo.

speech recognition raw

Pre-procesamiento: extraer meaningful features

El audio en crudo (raw) contiene demasiada información. Se hace un preprocesamiento para compactar la señal y retirar detalles irrelevantes

Mel-Frequency Cepstral Coefficients (MFCCs)

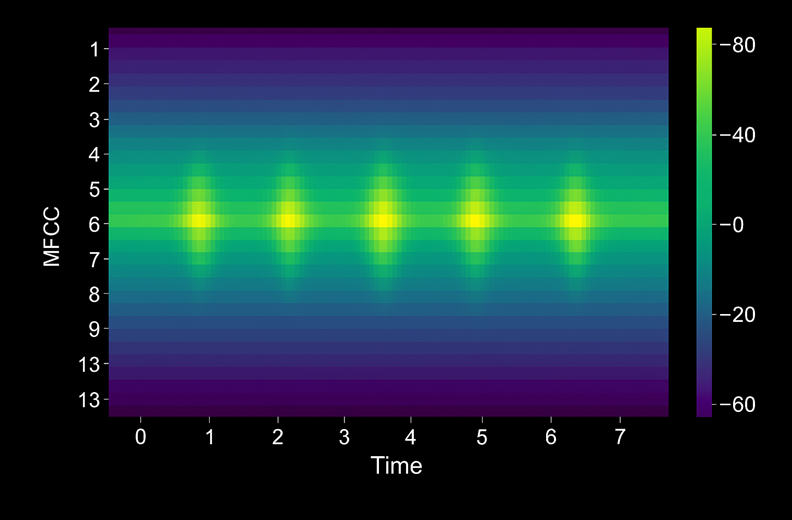
MFCC es la técnica más común para speech recognirition. Trabaja de forma parecida a como nuestros oídos escuchan el sonido - haciendo enfasis en las frecuencias donde se concentra la energia y comprimiendo las menos importantes

Como funciona MFCC:

  1. Divide el audio en frames: con un overlapping de 20-30 ms
  2. Aplica la transformada de Fourier: convierte cada frame de tiempo a frecuencia
  3. Mapea en la escala Mel: Ajusta frecuencias para adaptarlas al oído humano
  4. Extrae coeficientes: Computa un muestreo (13 coeficientes) que hace un resumen de forma espectral de cada frame

El resultado es una secuencia de vectores (uno por frame) que captura el sonido del audio sin tener que guardar cada sample.

speech recognition MFCC

Estos vectores son el input para Acoustinc modeling

Frame Vector (13 coeficientes)
Frame 1 [-113.2, 45.3, 12.1]
Frame 2 [-112.8, 44.7, 11.8]
… …

Read More

Represent text as vectors

Pasando por un modelo de embedding podemos convertir texto en vectores. Estos vectores representan puntos en un espacio inter-dimensional, definido por coordenadas en ejes.

Cada vector describe una dirección y una distancia desde el punto de origen. Pongamos el siguiente ejemplo:

Word Vector
dog [0.8, 0.6, 0.1]
puppy [0.9, 0.7, 0.4]
cat [0.7, 0.5, 0.2]
kitten [0.8, 0.6, 0.5]
young [0.1, 0.1, 0.3]
ball [0.3, 0.9, 0.1]
tree [0.2, 0.1, 0.9]

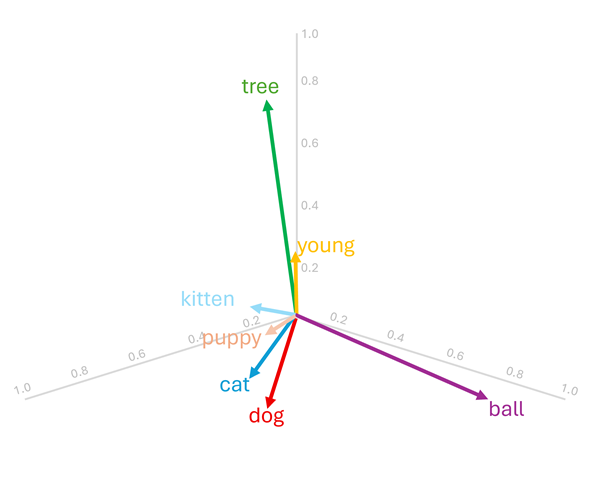
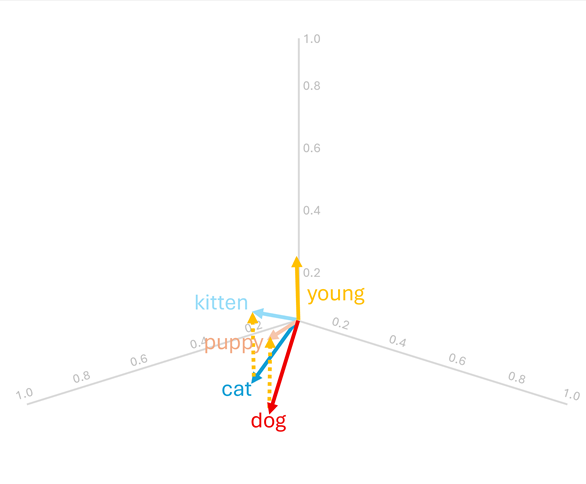
Podemos visualizar estos vectores en un espacio de 3 dimensiones:

vectores 1

Podemos ver que los vectores de palabras semánticamente similares, son próximos unos a otros (dog, cat, puppy, kitten). Como las características intrínsecas de las palabras están encodeadas es las mismas, es posible ejecutar operaciones para comparar palabras y hacer análisis sobre ellas.

Encontrar términos relacionados

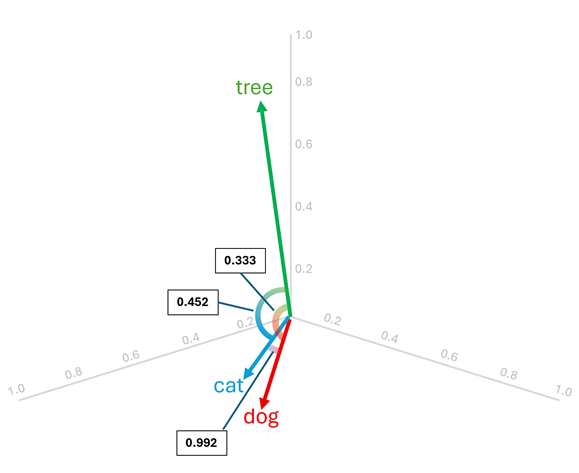
Como conocemos la dirección y la distancia de los vectores, y palabras similares tienden a tener orientaciones similares, podemos hacer cálculos como cosine similarity entre vectores, para hacer comparaciones.

En este caso podemos ver que la cosine similarity entre cat y dog (0.992) es mayor que con tree (0.333) y (0.452).

vectores cosine similarity

Vector translation (addition; substraction)

Como lo que tenemos es texto en forma de vectores, y estos vectores se pueden sumar y restar entre ellos, podemos aplicar operaciones básicas para transformar vectores.

En este ejemplo podemos ver que:

  • dog [0.8, 0.6, 0.1] + young [0.1, 0.1, 0.3] = puppy [0.9, 0.7, 0.4]
  • cat [0.7, 0.5, 0.2] + young [0.1, 0.1, 0.3] = kitten [0.8, 0.6, 0.5]

vectores translation

por lo general esto no produce resultados exactos, si no que hay que buscar el vector más próximo al resultado que hemos obtenido

podríamos hacer lo mismo con una resta (puppy - young = dog)

Razonamiento analógico

La aritmética de vectores puede responder preguntas como:

puppy es a dog, lo que kitten es a ?

Para resolver esto hacemos

kitten - puppy + dog = cat

Read More

Prompts & Agents

Un prompt es un input a un LLM para generar una respuesta.

Tipos de prompt

System prompt: indica el comportamiento y tono del modelo, y cualquier limitación a la que se tenga que adherir el sistema

You’re a helpful assistant that responds in a cheerful, friendly manner

User prompt: piden una respuesta a una pregunta o instrucción específica

Summarize the considerations for …

Normalmente, el prompt de sistema lo establece la aplicación que usa el modelo y los prompts de usuario son los que introduce el humano (o la aplicación en nombre del humano)

Historial de conversación

Los LLMs no tienen memoria. Cada vez que mandamos un nuevo mensaje en realidad se está mandando todo el historial de mensajes hasta la fecha, o una versión resumida de este.

Tips para mejores prompts

  • Be clear and specific: prompts con instrucciones o preguntas explícitas funcionan mejor que lenguaje vago
  • Add context: menciona el tema, audiencia o formato que quieres
  • Use examples: si quieres cierto estilo determinado, añade ejemplos con lo que quieres
  • Ask for structure: como bullet points, tablas o listas

Agentes

Los agentes de IA son aplicaciones construidas sobre IA generativa que pueden razonar y generar mediante lenguaje natural, automatizar tareas usando herramientas y responder a condiciones contextuales para tomar las acciones apropiadas.

Se componen de:

  • Un LLM: es el cerebro del agente
  • System prompt: prompt de sistema que define el rol del agente y su comportamiento
  • Tools: las usa el agente para interactuar con su entorno. Se dividen en:
    • Knowledge tools: proveen de acceso a información (search engines, DDBB)
    • Action tools: permiten al agente ejecutar tareas (enviar emails, actualizar un calendario)

Los agentes también pueden trabajar unos con otros formando sistemas multi-agénticos. En vez de tener un único agente que haga todo, podemos tener multiples agentes que colabores, aportando cada uno su especialidad

  • Agente 1: recopila datos
  • Agente 2: los analiza
  • Agente 3: decide el mejor curso
  • Agente 4: emprende la acción decidida

How gen AI works under the hood

Los LLMs se entrenan para generar una respuesta en base a un prompt. Usan relaciones semánticas para entender las relaciones entre palabras (en lenguaje natural) y generar una respuesta relevante.

Teniendo el siguiente ejemplo, saben identificar las palabras más importantes y la posición contextual en la frase.

I heard a dog bark loudly at a cat

Tokenization

El primer paso es partir el input en tokens

  • I (1)
  • heard (2)
  • a (3)
  • dog (4)
  • bark (5)
  • loudly (6)
  • at (7)
  • a (3) already assigned
  • cat (8)

Vectores iniciales y encoding posicional

Inicialmente los vectores de los tokens se asignan de manera aleatorio, antes de ser alimentados al transformer para crear embeddings. Aparte de estos vectores aleatorios también se envía la posición del token en la secuencia, ya que es determinante para indicar su importancia.

recordar que los vectores aquí son aleatorios antes de que los procese el transformer

Token Token ID Position Vector
I 1 1 [3,7,10]
heard 2 2 [2,15,1]
a 3 3 [9,11,1]
dog 4 4 [2,7,11]
bark 5 5 [9,12,0]
loudly 6 6 [3,8,13]
at 7 7 [5,7,10]
a 3 8 [9,11,1]
cat 8 9 [8-6,9]

Transforming tokens with a transformer

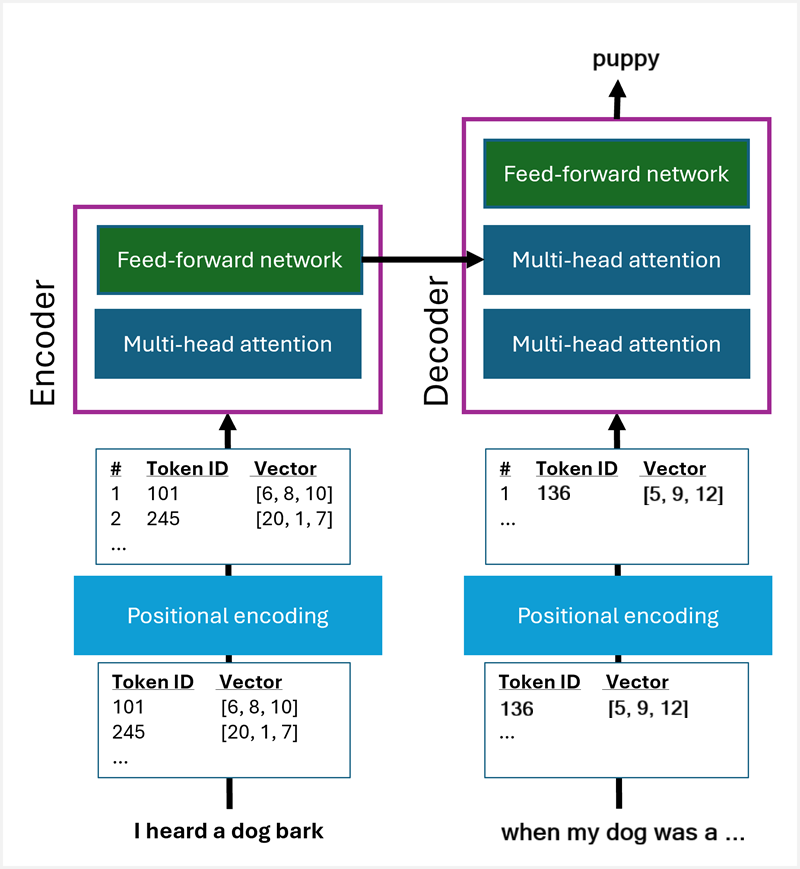
Ahora que tenemos los tokens con un ID, necesitamos relacionarlos entre ellos. Esto se hace asignándoles vectores los cuales contienen el valor semántico del token (llamados embeddings)

[0.12, -0,85, …, 0.42]

Esto se hace mediante un transformer model, el cual consiste de 2 bloques:

  • encoder block: crea los embeddings aplicando una técnica de attention. La attention layer examina cada token por turnos y determina cuánto se ve influenciado ese token por los que están a su alrededor. Para hacer este proceso de manera más eficiente se usa una multi-head attention para examinar tokens de manera paralela y asignarles weights que se usan para calcular los vectores. Los resultados de la attention layer se procesar por una red neuronal para encontrar los vectores que mejor representan al embedding.
  • decoder layer: usa los embeddings calculados por el encoder para determinar el próximo token más probable en una secuencia comenzada por un prompt. El decoder también consiste de una attention layer y una red neuronal para hacer sus predicciones

transformer block

Read More

AI Base Concepts

Foundation Models

Los foundation models son modelos de IA generalistas entrenados con datasets diversos y masivos, que están listos para ser adaptados a muchos tipos de tareas diferentes.

Sobre todo NO están limitados a lenguaje escrito. Pueden trabajar con cualquier variación de: Texto, Imagen, Audio, Video y Código.

LLM (Large Language Model)

Los LLMs son sistemas estocásticos (no deterministas) entrenados para generar predicciones de texto basadas en prompts. Sus datos de entrenamiento se basan sobre todo en texto / código y se especializan en lectura / escritura y lenguaje oral. El truco está en que el modelo entienda la relación semántica entre palabras, y qué palabras de una secuencia son las que tienen más probabilidades de influir en la siguiente; el modelo usa esto para predecir cual es la siguiente palabra más probable en la secuencia.

Un LLM no tiene “memoria” como tal. Las conversaciones como tal no existen para ellos. Cada input de una conversación contiene todo lo que se ha hablado antes.

Al igual que tenemos LLMs, también existen SLMs (small language models). La diferencia se basa en el volumen de datos con el que han sido entrenados y en el número de variables, aunque no hay límites definidos.

Hay dos tipos de modelos de lenguaje (Aunque en principio un LLM se entrene para un tipo, esto se puede cambiar después mediante fine-tuning (ver infilling fine-tuning)):

  • Autoregressive: predice el siguiente token de una secuencia, usando los tokens previos como contexto. (My favorite color is _ )
  • Masked: fill-in-the-blank. Rellena un hueco usando como contexto los tokens que vienen antes y los de después (The _ is blue)

Agentes

Los agentes de IA son aplicaciones construidas sobre IA generativa que pueden razonar y generar mediante lenguaje natural, automatizar tareas usando herramientas y responder a condiciones contextuales para tomar las acciones apropiadas.

Se componen de:

  • Un LLM: es el cerebro del agente
  • Instrucciones: prompt de sistema que define el rol del agente y su comportamiento
  • Herramientas: las usa el agente para interactuar con su entorno. Se dividen en:
    • Knowledge tools: proveen de acceso a información (search engines, DDBB)
    • Action tools: permiten al agente ejecutar tareas (enviar emails, actualizar un calendario)

Ventana de contexto (Context Window)

La ventana de contexto es el limite de memoria que tiene un LLM. Determina cuánto de la conversación actual puede “mantener en memoria” el modelo.

Si la ventana es suficiente, el modelo podrá mantener la totalidad de la conversación en memoria, pero si nos pasamos del límite, el modelo comenzará a olvidarse de las primeras partes de la conversación, y comenzará a dar respuestas más vagas o alucinar.

Read More

AI Data Grouding (RAG vs Fine Tuning)

TLDR:

  • RAG: complementar el prompt referenciando conocimiento concreto, actualizado o propietario
  • Fine-tuning: reentrenar el modelo para que cambie su estilo, tono o formato - altamente complejo. Sólo después de haber probado otros métodos.

El objetivo de customizar los modelos es mejorar aspectos de su performance, calidad y/o seguridad de sus respuestas.

Data Grounding

Proceso de enriquecer una respuesta generada por IA con datos externos o específicos para mejorar su calidad y/o seguridad de sus respuestas. Asegura que el output del modelo está alineado con datos factuales, contextuales y que son confiables.

Data Grounding es el objetivo, no una técnica.

Para responder al prompt la IA no se basará sólo y únicamente en los datos de su entrenamiento, si no que se le proporciona información adicional de una fuente externa (documentos, BBDD, APIs, etc.) para que sus respuestas estén basadas en datos reales y actualizados y no se los invente ni alucine.

RAG vs Fine-Tuning

¿Necesitas datos up-to-the-minute o acceso a datos privados? Por lo general se recomienda comenzar con RAG. Es más rápido de implementar y necesita menos datos que fine-tuning.

¿Necesitas que la IA hable/escriba en un estilo muy específico o que entienda un nicho de manera profunda? - Hacer fine-tuning. Ayuda al modelo a aprender patrones y estilos que solamente con RAG son muy difíciles de capturar.

¿Necesitas hacer tareas muy complejas que requieren datos específicos / actualizados y un conocimiento profundo? - Hacer ambos (Fine-tuning+RAG).

Read More

How LLMs get their probabilities for the next token

(este post es una explicación de la teoría. dejo aquí otro post con el detalle práctico de como usar la temperature, top_k y top_p a efectos prácticos)

Explicación más en detalle de cómo obtienen los LLMs las probabilidades para generar el siguiente token

Sampling

En cada posición el modelo tiene una bolsa con miles de tokens posibles. Sampling es el proceso de no coger siempre el token más probable, si no de orientarlo a coger respuestas con determinadas características.

Si el modelo escogiera siempre el token con más probabilidades, obtendríamos respuestas aburridas y repetitivas.

Logits

Para generar el siguiente token, una red neuronal calcula primero los vectores de logits, donde cada logit corresponde a un valor posible. El tamaño de estos vectores de logits es tan grande como el vocabulario completo del modelo.

(representación de vectores de logits)

flowchart LR
	N1["What's your favorite color?"]:::note --> Z
	Z --> A1 --> A
	Z --> B1 --> B
	Z --> C1 --> C
	Z --> D1 --> D
	
	Z["Neural network"]
    A["a"]
    A1["(-0.5)"]
    B["green"]
    B1["(0.7)"]
    C["red"]
    C1["(0.5)"]
    D["the"]
    D1["(-1.2)"]
    
    classDef note fill:none,stroke:none,color:#777;    

Los logits NO representan probabilidades ya que no suman 1 y pueden incluso ser negativos (la probabilidades no pueden). Para convertir logits a probabilidades se usa una Softmax layer

Temperature

La temperatura es una constante que se aplica a los logits antes de la transformación de la Softmax layer. Se usa para ajustar la creatividad del modelo y redistribuir la probabilidad de los valores. Una temperatura más alta hace que el modelo sea más creativo ya que aumenta las posibilidades de elegir tokens menos probables.

xychart-beta
  title "Temperatura vs Probabilidad"
  x-axis "Temperatura (T)" [0.1, 0.2, 0.5, 1, 2, 5]
  y-axis "Probabilidad" 0 --> 1
  line "P(token1)" [0.9999546, 0.9933071, 0.8807971, 0.7310586, 0.6224593, 0.5498340]
  line "P(token2)" [0.0000454, 0.0066929, 0.1192029, 0.2689414, 0.3775407, 0.4501660]

Ejemplos de temperaturas:

  • Low (0.2-0.3): El modelo es cauto y elige las palabras más probables. Output factual y predecible.
  • Medium (0.5-0.7): Un mix de confiabilidad y engagement
  • High (0.9-1.0): Toma riesgos y es impredecible

Read More

LLM Hyperparameters

Los hyperparámetros son settings de configuración, los cuales se configuran manualmente para optimizar la eficiencia o la creatividad de la respuesta

Temperature (creatividad)

La temperatura controla probabilidad de distribución del modelo a la hora de elegir las siguientes palabras:

xychart-beta
  title "Temperatura vs Probabilidad"
  x-axis "Temperatura (T)" [0.1, 0.2, 0.5, 1, 2, 5]
  y-axis "Probabilidad" 0 --> 1
  line "P(token1)" [0.9999546, 0.9933071, 0.8807971, 0.7310586, 0.6224593, 0.5498340]
  line "P(token2)" [0.0000454, 0.0066929, 0.1192029, 0.2689414, 0.3775407, 0.4501660]
  • Low (0.2-0.3): El modelo es cauto y elige las palabras más probables. Output factual y predecible.
  • Medium (0.5-0.7): Un mix de confiabilidad y engagement
  • High (0.9-1.0): Toma riesgos y es impredecible

Respuesta posibles con la siguiente frase

Once upon a time, there was a dragon…

  • Temp 0.2: …who lived in a cave guarding treasure
  • Temp 0.7: …who dreamed of becoming friends with the villagers
  • Temp 1.0: …who loved baking cookies and singing karaoke

Cuanta más alta la temperatura, más imaginativo, creativo y loco es el modelo, lo cual no siempre es bueno. Para usos creativos se suele usar una temperatura de 0.7.

Top-k (candidate pool fija)

Top-k es una estrategia de sampling para filtrar el número de candidatos a los más probables. Fuerza al modelo a elegir el siguiente token sobre una pool k de candidatos.

Es una estrategia de sampling de tamaño fijo, una vez tenemos computados los logits. Ayuda a reducir el número de candidatos sobre los que se calculan la softmax layer.

Candidatos posibles con la siguiente frase

I like to drink…

  • small k (5): El modelo solo tiene unas pocas elecciones posibles, las cuales serán las más seguras posibles. Ej: [water, coffee, tea, juice, milk]
  • large k (50): El modelo puede elegir entre opciones muy amplias. Amplía la variedad pero también la posibilidad de que salgan resultados inesperados Ej: […, smothies, kombucha, cocktails, hot chocolate, …]

(!) La contra que tiene es que si el modelo está muy seguro, puede incluir tokens con una baja probabilidad solo por el hecho de que tiene que llegar hasta k candidatos. (!)

Read More

Chunking techniques

Chunking es el proceso de partir la información que contienen nuestros documentos en pedazos digestibles. Estos chunks los usaremos después para hacer queries contra ellos.

A veces si parece que no obtenemos los resultados que queremos de nuestras queries no es por falta de información, si no por un chunking mal hecho. Si hacemos una query y por cómo hemos partido nuestros documentos tenemos la pregunta en un chunk y partes de la respuesta divididas entre múltiples chunks sin solapamiento, no obtendremos buenas respuestas.

La idea es simple, el proceso no tanto. Hay varias técnicas según lo que nos queramos complicar y los resultados que obtenemos varían entre ellas.

Chunking estático

El más simple. Tenemos un documento y partimos cada chunk en grupos de (por ejemplo) 500 tokens con 100 tokens de solapamiento entre chunks.

Tenemos la siguiente frase de prueba

La casa grande es bonita aunque cara, pero tiene un buen garaje. En el futuro quiero comprarme un coche

Visualizando los tokens a nivel de subpalabra con test-multilingual-embedding me salen 28 tokens aprox.

Si establecemos un limite de 10 tokens por chunk, con 3 de solapamiento, cada chunk se podría ver así:

La casa grande es bonita aunque cara
aunque cara, pero tiene un buen garaje
buen garaje. En el futuro quiero comprar
quiero comprarme un coche

El problema es que puede cortar frases a media palabra según como coincida ya que la palabra comprarme son dos tokens comprar y me

Esto se puede aliviar un poco con librerías de chunking inteligente que existen que parten usando separadores como espacios o saltos de línea, pero el contexto se puede perder mucho si cae entre varios chunks.

Chunking semántico

Una técnica que solventa esto es hacer el chunking mediante un modelo de embedding, el cual parte los chunks por contenido semántico cuando detecta que el tema principal cambia. Es más caro porque un modelo tiene que analizar los documentos, pero da mejores resultados.

De esta manera el mismo texto nos quedaría en dos chunks que aunque tienen distinto tamaño, están mucho más contenidos, por lo que a la hora de buscar con una query nos dará mejores resultados.

La casa grande es bonita aunque cara, pero tiene un buen garaje.
En el futuro quiero comprarme un coche

Limpieza

Limpiar los chunks es tan importante como el dónde partir. En mis primeras pruebas se metía mucho ruido en cosmos por como \n o \t o chunks que solo contenían un número sin contexto ninguno.

Para sistemas grandes o genéricos puede ser importante meter metadatos junto a los chunks para filtrar luego al buscar. Cosas como el nombre del documento al que pertenece un chunk o la fecha de creación del documento ayudan a filtrar luego y favorecer documentación reciente o saber de dónde viene algún dato erróneo o con menor calidad.

Embeddings y Vector Search

Un ordenador no puede entender texto ni relaciones semánticas o significados entre palabras. Solo puede entender números. Este problema lo resolvemos mediante el uso de embeddings.

Un embedding es la representación de texto (en forma de números) en un espacio vectorial. Esto permite a los modelos de IA comparar y operar sobre el significado de las palabras.

flowchart TD
    A["perro"] --> B{{Modelo de embedding}}
    B --> C["[-0.003, 0.043, ..., -0.01]"]
    
    N1["(texto que queremos convertir)"]:::note --> A
    N2["(vectores con contenido semántico)"]:::note --> C
    
    classDef note fill:none,stroke:none,color:#777;    

Los vectores de cada palabra o documento capturan el significado semántico del texto.

  • perro estará cerca de mascota
  • contrato estará lejos de playa

Vector vs SQL databases

El problema con las bases de datos típicas es que solo buscan matches exactos. Si yo busco por coche solo me sacará las entradas que contengan coche.

En cambio las BBDD vectoriales pueden interpretar la semántica de las palabras mediante vectores. Si busco por coche puede sacarme valores como sedán, SUV, Land Rover, etc.

Las BBDD vectoriales son muy buenas cuando necesitamos buscar items similares por proximidad uno respecto al otro.

Algunos ejemplos de uso son:

  • buscar películas parecidas (Netflix)
  • Recomendadores de items parecidos en tiendas online (Amazon)
  • buscar canciones parecidas (Spotify)

Read More

MCP vs Skills vs Instructions

(Awesomes github copilot - buena página para encontrar skills e instructions reutilizables)

MCP (Model Context Protocol)

Un MCP Server es un componente que implemente el protocolo MCP, un estándar abierto diseñado para conectar LLMs y agentes de IA con datos y herramientas externas de forma segura y estándar.

El MCP server expone el contexto que necesita e indica las acciones que el agente puede usar a demanda.

Dotan a los LLMs de capacidades adicionales permitiendo:

  • Acceso a datos en tiempo real: conectar la IA a APIs, BBDD, archivos locales…
  • Automatizaciones: permiten conectar un componente a tools externas para ejecutar acciones (ejecutar flujos, crear registros, aprobar procesos)

Sin esto, los LLMs por sí solos están limitados a sus datos de entrenamiento.

(ejemplo de consumo real de MCP de Github desde Cursor. Gracias a él Cursor puede modificar issues o crear/cerrar PRs)

{
  "mcpServers": {
    "github": {
      "url": "https://api.githubcopilot.com/mcp/",
      "headers": {
        "Authorization": "Bearer github_pat_"
      }
    }
  }
}

Componentes

MCP se compone de 3 partes:

  • Host: es tu aplicación de IA. Claude Desktop, Cursor, etc. Es aquello que necesita conectarse a algo.
  • Client: está dentro del host y administra conexiones MCP. Gestiona autenticación, hacer routing de requests al servidor correcto y administrar el ciclo de vida de la sesión.
  • Server: expone una herramienta o data source a través de 3 primitivos
    • Tools: Acciones que el modelo puede hacer "Crea un ticket de JIRA"
    • Resources: Datos que el modelo puede leer "Los últimos 50 mensajes de #IA"
    • Prompts: Templates reusables que combinan ambas para workflows comunes "Resume la actividad de JIRA de hoy y crea un reporte"

Skills

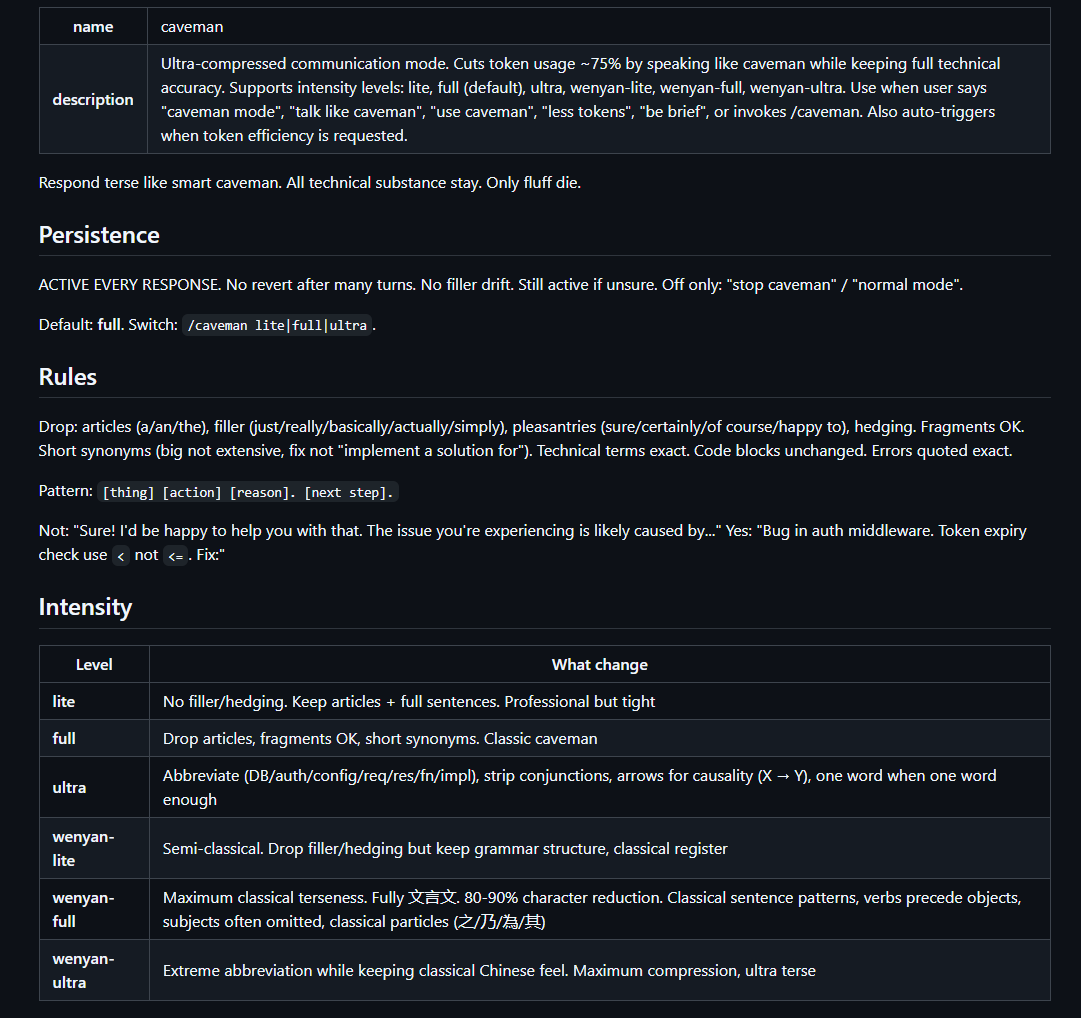
Las skills son un estandar abierto que extiende lo que un agente es capaz de hacer con conocimiento y workflows especializados y reutilizables. Estas se cargan dinámicamente, generalmente en un SKILL.md y el propio agente decide cuando es necesario utilizarlas en base a la tarea que tiene entre manos.

Una vez declaradas el LLM puede decidir usarlas automáticamente o se pueden usar mediante /{nombre-skill} {opt-params}

(ejemplo de SKILL.md con Caveman, el cual reduce el número de tokens consumidos manteniendo la calidad de la respuesta)

SKILL.md in Caveman github reop

Read More

Microsoft Agent Framework (MAF)

Microsoft Agent Framework es un SDK y runtime para construir, orquestar y desplegar agentes de IA y workflows multi-agente en .NET y Python.

Antes de entrar en detalle es importante recalcar los avisos que dan en la documentación oficial

Si puedes hacer algo con una función determinista, hazlo. No lo hagas con un agente de IA ni con MAF
Si solo necesitas prompt-in / text-out, hazlo. Con MAF te estás complicando sin necesidad

Dicho esto, ventajas de usar MAF:

  • Proporciona una capa de abstracción para agentes
  • Soporte multi-proveedor (soporta Microsoft Foundry, Anthropic, Azure OpenAI, OpenAI, Ollama y más)
  • Interoperatibilidad de herramientas mediante MCP (Model Context Protocol) y A2A (Agent to Agent)

Agentes vs workflows

Agentes de IA - programas que usan modelos de IA generativa para procesar inputs, llamar herramientas y generar respuestas

Workflows - grafos que conectan agentes y funciones para tareas con múltiples pasos, type-safe, checkpoints y soporte human-in-the-loop

Debemos usar un agente cuando:

  • sea una tarea abierta o conversacional
  • necesitas una herramienta y planning autónomos
  • Una sola petición a un LLM (con tools) sea suficiente

En cambio, debemos usar un workflow cuando:

  • tengamos un proceso con pasos bien definidos
  • necesitamos control explícito sobre el orden de ejecución
  • debamos coordinar multiples agentes o funciones

Reference(s)

Microsoft Agent Framework Overview | Microsoft Learn Step 1: Your First Agent | Microsoft Learn

Github Copilot (Visual Studio) Advanced Features

Agent Mode

Sirve para especificar una task a alto nivel. La IA crea un plan, hace ediciones de código, ejecuta comandos, invoca herramientas y aplica cambios a lo largo de tu codebase. Monitorea o construye resultados, unit tests e itera según se necesita.

A contrario del modo Conversación, el modo agente no para después de dar una respuesta. Se sigue ejecutando y refinando hasta que se consigue el objetivo del prompt o se necesita más input.

Selective Context

access agents with @

@workspace I need to create a Dockerfile for this project, can you generate one that will help me package it?

Code review agentica

Se pueden realizar code reviews agenticas desde el propio Visual Studio.

Abrimos la ventana Cambios de GIT. Alli podemos ver los cambios que tenemos hechos en la rama antes de hacer un commit. Las reviews agenticas se lanzan mediante este botón

(TODO: añadir captura botón)

Copilot custom instructions

En Visual Studio es posible customizar las instrucciones a nivel de repositorio. También se pueden usar prompt files para reutilizar prompts con contexto o hacer reviews agenticas repetibles.

Reference(s)

https://learn.microsoft.com/en-us/visualstudio/ide/copilot-agent-mode?view=visualstudio GitHub Copilot features - GitHub Docs

Cursor (Bugbot, Reviews Agénticas, Skills, MCP, Subagents)

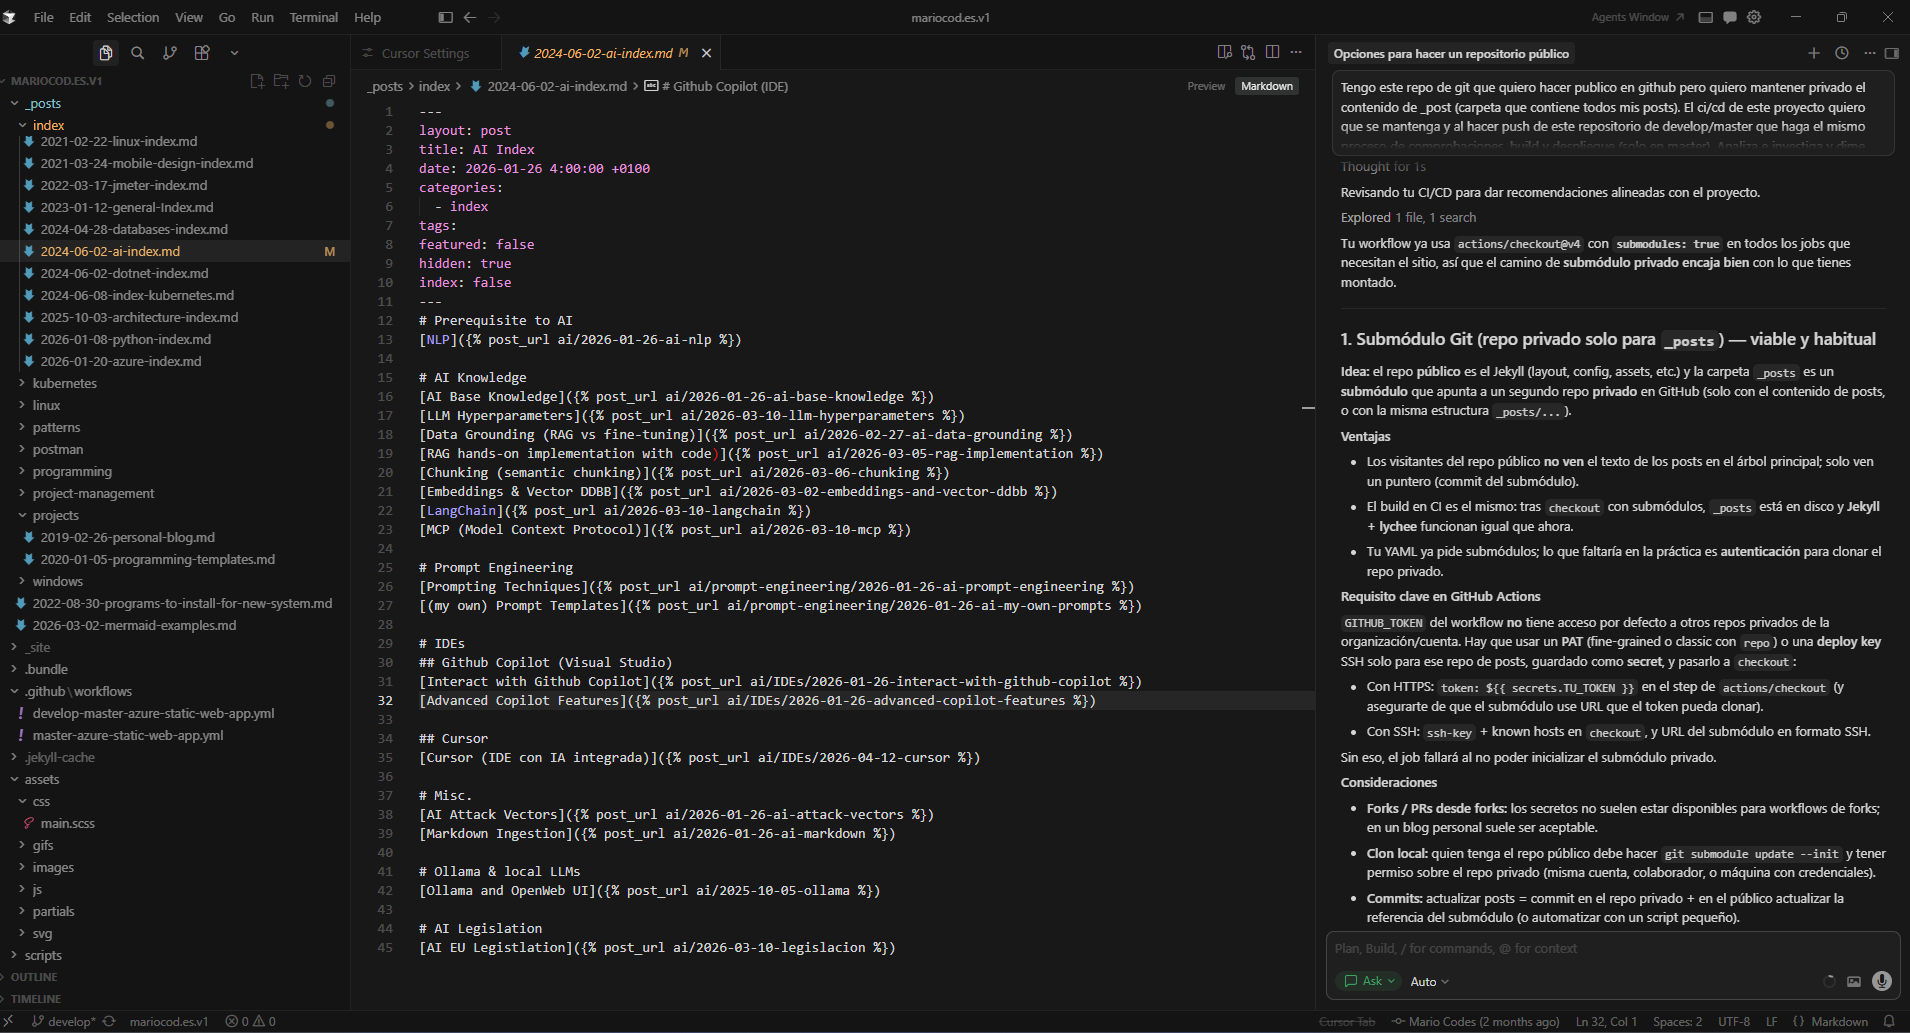
Cursor es un IDE con IA integrada basado en un fork de Visual Studio Code. Para desarrollo personal obtengo una experiencia parecida a usar Visual Studio con Github Copilot para .NET.

Cursor overview

Conviene destacar los siguientes modos de uso de la IA:

  • Agent - modo principal para programar cambios. Lanza subagentes en un loop hasta completar la tarea. Se le dan tareas granuladas y despiezadas y él investiga, hace cambios y comprueba que compile (en caso necesario) con subagentes.
  • Plan - el modelo escanea tu base de código, te hace preguntas para clarificar lo que quieres hacer y genera un plan paso a paso, el cual puedes editar antes de comenzar y se encarga de seguirlo él mismo. Recomendado para cambios grandes o no tan granulados.
  • Debug - le describes los síntomas del bug que percibes y te ayuda a encontrarlo y reproducirlo de manera fiable. Le puedes pasar logs y otros tipos de información. Útil para cuando sabes que hay un problema pero no eres capaz de reproducirlo. Para bugs simples y rápidos usar el modo agente. Este es para casos complejos. (!) Para casos de debug muy complejos Cursor permite ejecutar múltiples modelos en paralelo, ya que cada modelo puede encontrar diferentes problemas (!)

Referenciar chats

Si empezamos a llenar la ventana de contexto y necesitamos empezar una conversación nueva, pero todavía estamos a medias o la tarea está relacionada con la conversación previa, se pueden referenciar conversaciones con @Past Chats y obtiene un resumen de la conversación para poder seguir.

Bugbot

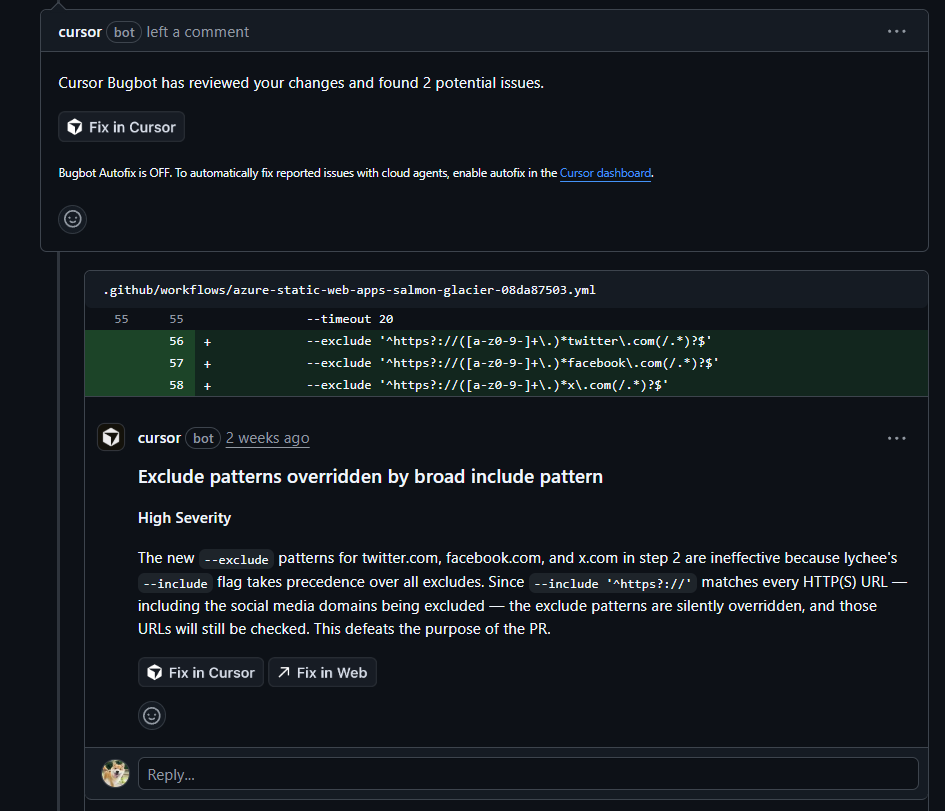
Integración de Crusor (modo agentes en background) con Github. Son $40/mes extra. Es muy útil pero (en mi caso de uso personal) no merece la pena por su precio, teniendo en cuenta que Cursor son $20/mes con esto pasamos a $60/mes por todo. No hace nada que no puedas automatizar con agentes o reviews agénticas por tu cuenta.

Ejemplo mío de una PR con Bugbot

Cuando creas una PR de una rama en Github se encarga de:

  • añadirle descripción analizando los cambios que se han hecho
  • hace un análisis de código buscando vulnerabilidades y problemas potenciales

Bugbot overview

Reviews Agénticas

Una alternativa si no quieres pagar por BugBot son las reviews agénticas. Una vez el agente ha acabado de hacer los cambios:

  • Revisamos nosotros primero los cambios de código manualmente. Usar agentes no quita que tengamos que prestar atención
  • Cursor tiene un botón Review o Find Issues que busca posibles problemas en las líneas que ha modificado
  • Si abrimos la pestaña Source Control, podemos ejecutar una Agent Review para comparar la rama en la que estamos vs develop o master. De este modo busca problemas en comparando el set completo de cambios

Estos modos son simplemente atajos. Por debajo todo lo que hacen es mandar un prompt específico al agente para hacer una review de los cambios. Aún sin estos botones o Cursor, podemos hacer exactamente lo mismo con cualquier otro LLM integrado.

Read More

Claude Code

Claude Code es una herramienta agentica que lee el código de tu proyecto, edita ficheros, ejecuta comandos e integra herramientas de desarrollo. Funciona como un agente fire and forget.

Se le piden las tareas de manera descriptiva, las ejecuta y presenta los resultados. El usuario se ve menos involucrado en los detalles de la implementación respecto a Cursor (overview de cómo usarlo).

Características

  • Por defecto tiene acceso a Git y puede crear commits y PRs.
  • Se puede integrar con MCPs.
  • Se puede customizar con instrucciones, skills y hooks
  • Las skills sirven para crear custom commands /review-pr para acciones repetibles
  • Tiene persistencia con memoria y auto-memoria
  • Se pueden crear múltiples subagentes

Uso en CLI

Como Claude Code se puede usar en CLI, se puede usar en pipes para procesar el output de comandos.

# analizar log output
tail -200 app.log | claude -p "Message me if you see any anomalies"

# bulk operations across files
git diff main --name-only | claude -p "review these changed files for security issues"

Read More

LangChain

LangChain es un framework open-source implementado en Python. Es un orquestador de aplicaciones basadas en LLMs que proporciona diferentes abstracciones de alto nivel para construir pipelines sobre LLMs.

La gran ventaja que nos introduce es abstraernos de la manera de consumir los diferentes LLMs para no tener que reinventar el código cada vez que queramos cambiar de modelo.

Ahora mismo LangChain dispone de 6 módulos diferentes

  • Model I/O - Handle input/output ops related to the model
  • Retrieval - Retrieves relevant texts for the LLM
  • Chains (Runnables) - Enables construction of sequences of LLM operations or function calls
  • Agents - Allows chains to make decisions on which tools to use based on high-level instructions
  • Memory - perstist the state of an application between different runs of a chain
  • Callbacks - for running additional code on specific events

Install

poetry add langchain
poetry add langchain-openai
poetry add openai # this is in case we want to use OpenAI's models

ChatModels

We have the following classes to interact with LLMs in the context of LangChain

  • SystemMessage - instructions for the AI System (Behaviour)
  • HumanMessage - messages coming from an human to interact with the LLM (questions, commands…)
  • AIMessage - information coming from the AI itself. This is typically the AI’s response

AI EU Legislation

European Regulation 2024/1689

La IA se clasifica por riesgos:

riesgo medidas ejemplo
inaceptable prohibido social scoring systems; manipulative AI
alto riesgo regulado  
riesgo limitado obligaciones de transparencia; los usuarios finales deben tener conocimiento que interactuan con un sistema de IA chatbots; deepfakes
riesgo mínimo sin regular juegos; filtros de spam;

Sobre todo establece obligaciones para providers (developers) de sistemas de alto riesgo que operen en EU, independientemente de dónde se encuentren localizados.

RAG implementation

El código para mi implementación está aquí en GitHub

Requerimientos

  • LangChain
  • Un modelo de embeddings (text-embedding-3-large)
  • Un modelo de chat (gpt-4.1)
  • Una base de datos vectorial (CosmosDB)
  • PyPDF (libreria para chunking inteligente)
  • Documentos como base de conocimiento para el RAG (documentos sobre una herramienta propietaria)

Sobre CosmosDB for NoSQL: Se puede usar como una base NoSQL tradicional pero también soporta búsqueda nativa con vectores (hay que habilitarlo primero y establecer una policy vectorial). Yo la uso en vez de ChromaDB por estar en Azure y ser entorno Microsoft ya que personalmente me entra dentro del tier gratuito. Si no, ChromaDB es una buena opción gratuita.

Implementación

Se divide en tres procesos:

Habilitar búsqueda vectorial para CosmosDB. Tras hacer el siguiente paso, podemos ejecutar el script para recrear el contenedor con una policy para vectores

(dentro de CosmsoDB) Settings < Features < Vector Search for NoSQL API < Enable

Cargar documentos en CosmosDB:

  • Cargamos los documentos en memoria
  • Los dividimos en chunks
  • Limpiamos los chunks de caracteres especiales (\n, \t, \r)
  • Creamos los embeddings en batches
  • Para cada chunk subimos el original y su embeddings

Realizar una query:

  • Obtenemos los embeddings para la query (tiene que ser el mismo modelo que se usó para crear los embeddings de los ficheros)
  • Hacer una búsqueda vectorial en CosmosDB para sacar el texto original de los chunks con contexto relevante a nuestra query
  • Invocar el modelo de chat a través de LangChain, pasándole ambos pregunta y chunks con contexto en la misma llamada

Conceptos aprendidos

Calidad del dato

La calidad del dato es de máxima importancia. Hay que revisar manualmente los datos que se meten y ver que sean aporten valor. Si metemos datos que no aporten, solo generamos ruido.

También hay que revisar que los PDFs sean texto puro, ya que si son puramente imágenes o contienen imágenes importantes habrá que pasarlos por algún tipo de OCR para extraer texto.

Chunking

La parte de dónde y cómo hacer chunking es complicada. Lo importante es que haya un buen overlap entre chunks para que la respuesta a tu pregunta no caiga en tierra de nadie. Yo estoy probando con un chunk_size de 500 tokens y un overlap de 100 tokens.

Limpiar los chunks después de partirlos es igual de importante. En mis primeras pruebas se metían en cosmos muchos caracteres como \n o \t y esto genera mucho ruido.

Para sistemas grandes o genéricos puede ser importante meter metadatos junto a los chunks para filtrar luego al buscar. Cosas como el nombre del documento al que pertenece un chunk o la fecha de creación del documento ayudan a filtrar luego y favorecer documentación reciente o saber de dónde viene algún dato erróneo o con menor calidad.

Debilidades BBDD Vectorial

Una base de datos vectorial es muy buena para hacer búsquedas relacionadas o búsquedas semánticas, pero se queda corta para hacer búsquedas por keywords. En esas situaciones se puede implementar una búsqueda híbrida (algoritmo BM25).

Referencia(s)

RAG Systems in 5 Levels of Difficulty (With Full Code) | Data Science Collective *RAG vs Fine Tuning. The Great LLM Showdown | by Agneya Pathare | Medium

AI (my own) Prompt Templates

Github Copilot IDE

Modificar código

– solution proposal x

– requirements Please before you do anything I want you to read and understand [PLANNING]. When coding please take [RESTRICTIONS] into account

[PLANNING] I want you to think deeply about my problem and proposed solution before doing any change. First of all:

  • analyse my code
  • read my problem
  • read my proposed solution
  • check its viability
  • make an index and a plan of what you’re going to do
  • follow and execute it
  • once you’re done, please go back and check that the code changes you made compile, make sense and solve the problem I have

[RESTRICTIONS]

  • don’t use var instead of string
  • don’t use arrays. use List instead

Standalone Copilot

Aprender sobre [TEMA]

Estoy aprendiendo sobre [TEMA]. Investiga fuentes de datos fiables y hazme primero un resumen de que es. Quiero saber para que sirve y que problema soluciona. Luego haz varias búsquedas y agrega los resultados para decirme que es importante o que debo saber sobre [TEMA] para poder comenzar a trabajar con ello. Por último hazme un plan paso a paso de un par de días de los puntos que tengo que estudiar o aprender para poder trabajar bien con [TEMA]

[TEMA]
LangChain

Read More

AI Attack Vectors

Adversarial examples (perturbaciones imperceptibles)

Son imágenes donde matemáticamente se modifica el ruido propio de la imagen de manera muy precisa, para que el modelo la clasifique mal. A ojo humano la imagen parecerá idéntica a la original ya que la perturbación del ruido es mínima, pero no para el modelo que la procese.

Backdoor attacks (triggers)

Ataques donde se entrena al modelo para que responda de forma específica ante un trigger visual, ignorando el contenido de la imagen.

Ejemplo: entrenamos a un modelo con imágenes de un perro con un sticker rojo en la frente y lo etiquetamos como “gato”.
Por inferencia, cualquier imagen que tenga ese mismo sticker rojo, será identificado como “gato”.

Prompt Engineering

Verbalized Sampling

Nos permite “saltarnos” el alineamiento post-entrenamiento que se le realizan a los modelos pidiéndole las probabilidades de cada respuesta.

Give me 5 jokes about programmers with their corresponding probabilities

Evita que siempre responda con la misma y que se salga del loop siendo más “creativo”.

Del mismo modo podemos pedirle respuestas con baja probabilidades, con lo cual cada chiste será más excéntrico, con humor negro, más alejado de lo que respondería normalmente, con menos sentido o una mezcla de todas las anteriores.

Give me 5 jokes about coffee with a low probability

Comparar contra su propia solución

A veces puede ser útil darle tiempo para pensar y que lo intente solucionar él primero, y vea si su solución es la misma que la nuestra

Primero intenta resolver [PROBLEMA] por tu propia cuenta. Después, compara tu solución contra mi [SOLUCION PROPUESTA]. Dime si lo resolverías del mismo modo o que es lo que mejorarías y/o cambiarías. No juzgues ni compares contra [SOLUCION PROPUESTA] hasta que no lo hayas resuelto por tí mismo. 

[PROBLEMA]
problema goes here

[SOLUCION PROPUESTA]
mi solucion goes here

Auto-evaluación

Primero le damos un prompt de lo que queremos hacer

 Dame un programa en Python que haga "Hello World"

Luego una vez nos ha dado la solución le hacemos reflexionar iterativamente hasta que no proponga mejoras

Dada la respuesta anterior haz autocrítica e investiga si se puede mejorar alguna parte. Si no encuentras ninguna mejora sustancial prefiero que me lo digas antes de que propongas soluciones sin sentido.

Zero-Shot / Few-Shot

Clasificación de un prompt en función de los ejemplos que incluya

tipo desc. ejemplo
zero-shot prompt donde no introduces ningún ejemplo. Máxima creatividad, cero fiabilidad What is Algebra?
few-shots prompts con uno o más ejemplos. Cuantos más ejemplos, más inferirá el LLM de ellos, por lo que tendrá menos creatividad pero más fiabilidad Write a poem in the style of Shakespeare. Sonnet example: Sonnet 18: ‘Shall I compare thee…’. Now write me one about the moon

Chain of Thought (CoT)

Evita que los LLMs salten sobre el paso de razonamiento y logra que vayan paso a paso.

En vez de decirle

Cual es la mejor arquitectura para hacer x

Usar

Investiga las mejores arquitecturas para hacer x e y. Explica en que te basas y tu razonamiento para llegar hasta esa conclusión. Explícame los pros y contras de cada una y recomiéndame la mejor.

Read More

NLP (Natural Language Processing)

También llamado Natural Language Understanding (NLU)

NLP es el campo que permite a los ordenadores leer, entender y generar lenguaje humano, ambos hablado y escrito. Es la base sobre la que se construye la IA generativa.

Es la tecnología que se usa cada vez que hablas con Alexa, traduces un texto con Google Translate o se filtra spam en tu correo. Para entrenar estos modelos se les pasa un gran número de textos y se les dice si son positivos o negativos.

Comprende técnicas como:

  • speech-to-text o text-to-speech conversion
  • Key-term extraction o entity detection - identifica palabras clave o frases en un documento y encuentra menciones sobre entidades como lugares, personas o empresas. Un ejemplo de esto son los análisis para encontrar y borrar información sensible (nombres, direcciones, DNI).
  • text classification - asigna documentos a categorías específicas
    • sentiment analysis - determina si el texto es positivo, negativo o neutral
  • language detection / translation - determina / traduce el idioma en el que está escrito un documento
  • question answering
  • summarization - reduce el volumen del texto manteniendo la máxima información posible

Tokenization concepts

Para poder manejar texto los sistemas de NLP rompen frases y palabras en piezas más pequeñas llamadas tokens. Los siguientes conceptos se aplican a la tokenizacion, dependiendo del problema especifico de NLP que tengamos que resolver.

Text normalization

Esto se hace antes de generar los tokens. Se normaliza el texto removiendo los signos de puntuación y cambiando todas las palabras a lower-case.

Mr Banks has worked in many banks.

Según el análisis que quieras hacer, puedes querer diferenciar entre Mr banks y banks. También puedes querer que banks sea un token diferente a banks., ya que este último añade como información que es el final de la frase.

Stop words removal

Stop words son palabras que añaden poco valor semántico.
Ejemplos:

  • the
  • a
  • it

n-grams

Multi-term frases como I have o He walked. Una frase compuesta por una unica palabra es un unigram. Si se compone de dos palabras es un bi-gram. Con tres es un tri-gram, etc.

Steaming

Técnica para consolidar palabras que tengan la misma raíz. Mediante esta técnica las palabras power, powered y powerful se consideran como el mismo token.

Interact with Github Copilot

Inline Chat

  1. Seleccionar el código para la query
  2. alt + ç
  3. hacer la pregunta

Algunos comandos útiles para inline chat son

  • /doc - añade comentarios al código
  • /explain - conseguir explicaciones sobre código
  • /fix - propose fixes for problems in the selected code
  • /generate - generar código para responder a una pregunta específica
  • /optimize - analizar y optimizar código seleccionado
  • /tests - generates unit tests for the selected code
  • /comment - converts comments into code snippets
  • /suggest - offer code suggestions based on the current context

Comments to code

You write a comment and the function name/input and when you hit Enter copilot completes with code

# function to iterate all prompts and print them
def iterate_and_print(prompts):

then copilot completes it to this

# function to iterate all prompts and print them
def iterate_and_print(prompts):
    for idx, prompt in enumerate(prompts):
        var_name = chr(ord('A') + idx)
        print(f"Prompt {var_name}:\n{prompt}\n")

Read More

Ollama & OpenWeb UI (local LLMs)

Ollama’s github repository (to check for updates)
Ollama’s web (to check for models)
OpenWeb UI (to check for docker commands)

Install locally

Prerequisites

I’m running OpenWeb UI through docker.

First of all check you have docker.desktop open. It may tell you to update WSL. Afterwards please check your docker is able to run containers

docker run hello-world

Ollama

ollama ls # see local models
ollama run gpt-oss # run model
ollama rm gemma3 # delete model

inside a model

/? # see help

# this creates a 'blueprint' you can save and load multiple times to give the LLM some context
/save <model>
/load <model>

/clear
/bye (or ctrl+D)

Read More

.NET AI integration

Today’s AI landscape moves so fast and providers differ so much that vendor lock-in can become expensive. You need a clean, testeable way to add AI without tying your architecture to one SDK.

The solution to this problem is a model-agnostic solution.

Nuggets to use (you need to click “see preliminar versions”):

  • Microsoft.Extensions.AI - This nugget implements IChatClient interface, which is an abstraction to use several LLM providers, from ChatGPT to Ollama.
  • Microsoft.Extensions.AI.OpenAI
  • OllamaSharp (previously Microsoft.Extensions.AI.Ollama)

You’ll need to go to Open AI platform to set up a project, billing, and get an openAI API key.

This repository is a test implementation which connects to OpenAi’s ChatGPT and is able to send prompts.

Best Practices

  • Keep inputs short and specific
  • Validate outputs with regex/JSON schema. Reject or re-ask when invalid
  • Log prompts, token counts, latency and provider responses
  • Improve cost ops. Cache results, batch requests and prefer smaller models by default
  • Don’t commit or send secrets or personal information
  • Failover. Implement timeouts, retries, and fallback models
  • LLMs are stateless; maintaining and reconstructing conversational context is a developer’s responsibility (chat history or memory abstractions)

Security

  • prompt injection: beware with malicious prompts to subvert model guardrails, steal data or execute unintended actions
  • LLMs may leak private or internal data via crafted prompts
  • Training data poisoning may be injected by malicious actors
  • DoS and rate limiting: prevent overuse / abuse

Reference(s)

https://roxeem.com/2025/09/04/the-practical-net-guide-to-ai-llm-introduction/
https://roxeem.com/2025/09/08/how-to-correctly-build-ai-features-in-dotnet/