NLP es Natural Language Processing
NLU es Natural Language Understanding
Partimos de la base que tenemos un texto ya partido en tokens
- We
- choose
- to
- go
- to
- the
- moon
Técnicas Pre-procesamiento
Antes de hacer ningún tipo de procesamiento de lenguaje, pre-procesamos los tokens en función de lo que queramos conseguir
| Técnica | Descripción |
|---|---|
| Text normalization | Antes de generar el token podemos querer normalizar el texto en función de nuestro análisis (quitar signos puntuación, todo a minúsculas). Esto puede ayudar para análisis de frecuencia de palabras pero perdemos significado semántico.Mr Banks has worked in many banks. quizás queramos diferenciar entre la persona y el banco, o entre banks. y banks. Ese punto añade información de que la frase termina |
| Stop word removal | Stop words son palabras que se deben excluir del análisis ya que no aportan nada. Por ejemplo the, a, it |
| N-gram extraction | Encontrar frases que se puedan representar de diferentes maneras: artificial intelligence o natural language processing. Una frase con una palabra es un unigram, con dos palabras es bigram, con tres trigram |
| Stemming | Técnica para consolidar palabras quedándote solo con la raíz: si de las siguientes palabras powering, powered, powerful quitamos las terminaciones ing, ed, ful nos queda el mismo token power |
| Lemmatization | Otra forma de reducir palabras a su forma base (llamada lemma). A diferencia de stemming no acorta las palabras si no que se basa en linguistica y vocabulario para asegurarse que el resultado es válido. Ejemplo running -> run o global -> globe |
| Parts of speech (POS) tagging | Poner labels a cada token con su categoría gramatical (noun, verb, adjective or adverb). Tiene en cuenta el token y su contexto en la frase |
Statistical text analisis
Una vez tenemos ya hecho el pre-procesamiento y los tokens, podemos hacer análisis sobre documentos
Frequency Analysis
La forma más obvia en analizar un único documento aislado. Consiste en contar el número de veces que aparece un token en un documento.
| Term | Frequency |
|---|---|
ai |
4 |
business |
3 |
benefit |
2 |
No es ideal para comparar varios documentos que traten sobre un mismo tema ya que todo lo que veremos es que tratan sobre ia y beneficios (temas parecidos), pero no nos ayuda a discriminar cada documento individual.
Term Frequency - Inverse Document Frequency (TF-IDF)
Soluciona el caso anterior: Queremos saber cuán frecuente es un token en un documento, comparado con su frecuencia en la colección entera de documentos.
Nos sirve para identificar términos altamente relevantes en un documento particular. Se considera altamente relevante cuando es muy frecuente en un documento pero raro en el resto.
Pasos:
- Calculate Term Frecuency (TF): cuantas veces una palabra aparece en un documento
- Calculate Inverse Term Frequency (IDF): cuantas veces aparece en la colección entera de documentos
- Combine them (TF-IDF): Sigue una fórmula que no voy a entrar en detalle
Una TF-IDF alta nos indica que un término aparece mucho en un doc, pero es raro en toda su colección.
documento 1
| Term | Frequency |
|---|---|
copilot |
2.0794 |
studio |
2.0794 |
declarative |
1.3863 |
documento 2
| Term | Frequency |
|---|---|
code |
2.0794 |
develop |
2.0794 |
foundry |
2.0794 |
De esta forma aunque ambos documentos traten sobre el mismo tema general, podemos diferenciarlos en su conjunto.
“Bag-of-words” ML techniques
Técnica de extracción que representa tokens de texto como un vector de frecuencia de aparición de palabras, ignorando la gramática y el orden de las palabras.
TextRank
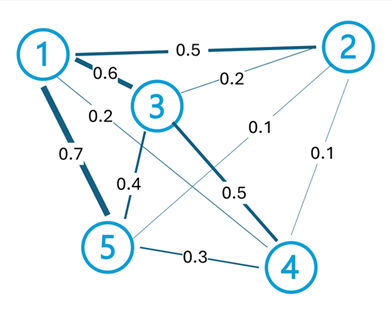
Algoritmo no supervisado basado en grafos que modela texto como una red de nodos conectados.
Por ejemplo cada frase en un documento se puede considerar un nodo, y se les asigna puntuación a las conexiones entre ellas en función de la similaridad de sus palabras.
Se usa para sumarizar textos identificando un subset de frases en un documento que mejor lo representan.
- Construir un grafo: cada frase es un nodo se les asigna puntuación a las conexiones
- Calcular rangos iterativamente: cada nodo se puntua basado en las puntuaciones de los nodos cercanos
- Extraer las frases con más puntuación: el resumen se obtiene sacando las frases mejor puntuadas