Esto se utiliza para extraer datos estructuradas desde media no estructurada como documentos, imágenes, audio o vídeo.
Optical Character Recognition (OCR)
Tecnología que convierte formatos visuales en texto.
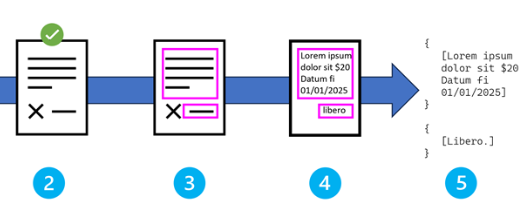
- Preprocesamiento y mejoras de la imagen
- Detección de zonas de texto
- Character recognition and classification
- Output generation and post processing
Preprocesamiento e image enhancement
Antes de comenzar con la detección de texto se aplican técnicas para optimizar y mejorar la imagen
- Noise reduction: remueve artefactos visuales, polvo o imperfecciones.
- Contrast adjustment: mejora el contraste entre texto y fondo
- Correción de desvíos (horizonte): alinea la rotación del documento
- Resolution optimization
Text region detection
El sistema identifica las áreas que contienen texto usando las siguientes técnicas
- Layout analysis: distingue entre zonas de texto, imágenes o gráficos y zonas en blanco
- Text block identification: agrupa caracteres en palabras, lineas y parrafos
- Reading order determination: de izq a derecha, top to bottom o viceversa
- Region classification: identifica headers, body text, tables
Character recognition
Es el core del OCR.
- Feature extraction: Analiza la forma y tamaño de cada simbolo
- Pattern matching: Compara las caracteristicas extraidas contra modelos
- Context analysis:: Analiza el contexto
- Confidence scoring: Asigna una probabilidad
Output generation and post-processing
- Text compilation: junta los caracteres individuales en palabras y frases completas
- Format preservation: mantiene la estructura como párrafos o line breaks
- Coordinate mapping: recuerda la posición de cada elemento en la imagen original
- Quality validation: aplica reglas de gramática para identificar errores
Field extraction and mapping
Field extraction es el proceso de tomar el output de OCR y convertirlo en dato estructurado.
OCR te dice que contiene un documento, field extraction te dice que significa y como encaja en tu sistema
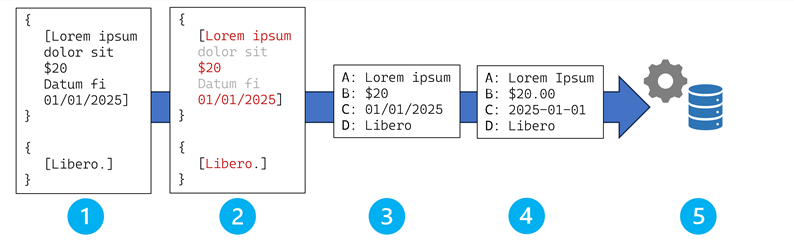
- OCR output
- Field detection and candidate identification
- Field mapping
- Data normalization
- Integration with business processes
Field detection and candidate identification
Identifica los campos que son potencialmente interesantes. Hay varias formas de proceder.
- Template-based detection: Buscamos por labels predefinidas como
Date:oTotal: - ML-based detection: Se puede usar un corpus de documentos de ejemplo para entrenar un modelo para extraer campos.
- GenAI-based detection: Usamos prompts para que el LLM extraiga los datos