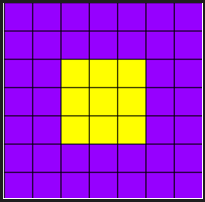
Para un ordenador una imagen es un array de pixel values.
(representación 7x7 de un cuadrado)
(pixel values)
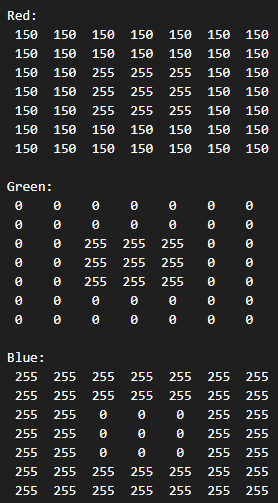
(pixel representation)
Filtros
Una manera de procesar una imagen es aplicar filtros que modifiquen los pixel values de esa imagen para crear un efecto visual. Un filtro se define por uno o más filter kernels (arrays de pixel values)
ejemplo de filter kernel 3x3

este filter kernel de 3x3 se irá ejecutando a lo largo de toda la imagen para obtener el resultado final

Si los valores se salen de la escala 0-255, estos se ajustan para que encajen de nuevo.
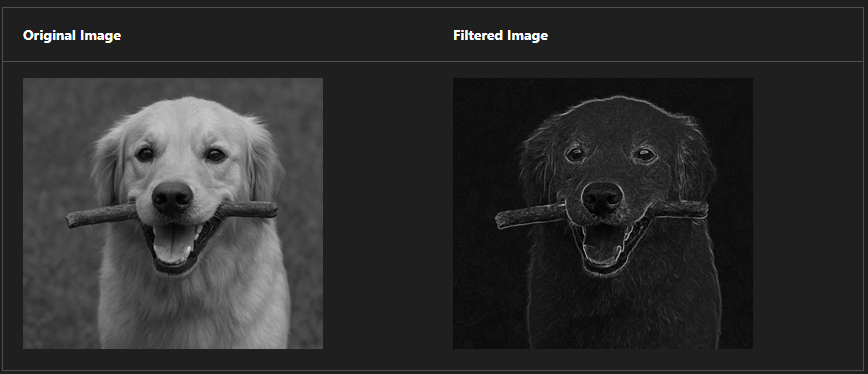
Este tipo de filtros se llaman convolutional filtering. Ejemplo de este tipo de filtros aplicado:
Convolutional neural networks
La abilidad de usar este tipo de filtros a imágenes se usa en image processing por ej. en software de edición de imágenes, aunque el objetivo de la computer vision por lo general es extraer significado o insights de imagenes
Uno de los tipos más comunes de machine learning para computer vision son las convolutional neural network (CNN), un tipo de arquitectura de deep learning.
Los CNNs usan filtros para extraer numeric feature maps de imagenes y pasarlas a deep learning models para generar predicciones de labels.
(ejemplo de image classification usando una CNN)
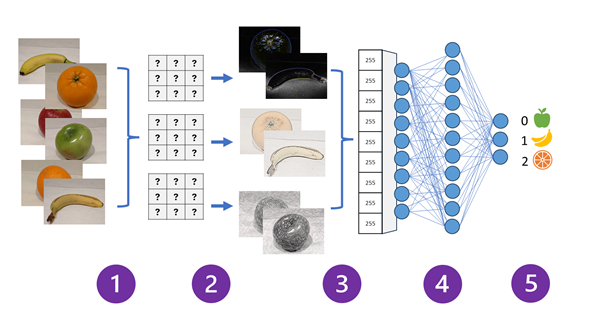
- Usamos como input imágenes de elementos conocidos para entrenar al modelo
- Se usan una o más capas de filtros para extraer características de cada imagen. Los filter kernels comienzan a asignar weights y arrays de valores numericos llamados feature maps. Estos se pueden comprimir para tener arrays más pequeños que enfaticen características visuales intrínsecas
- Los feature maps se aplanan en una única array unidimensional
- Los feature values se usan como input pawra una red neuronal
- La output layer de la red neuronal usa softmax (o una función similar) para producir resultados posibles para cada objeto en un rango de 0 a 1 [0.2, 0.5, 0.3]
Este proceso de entreno se repite durante múltiples epochs hasta que se aprende un set óptimo de weights. Estos weights se almacenan entonces y se usan para predecir nuevas imágenes donde desconocemos su label.