RAG (Retrieval Augmented Generation) es una técnica que complementa el prompt con información de diferentes fuentes de conocimiento externas, como documentos o emails, para aumentar el prompt con datos relevantes y basar la respuesta en esas fuentes.
La respuesta del modelo se basará en la información proveída (data grounding) y sirve para suplir carencias en los datos de entrenamiento de los modelos o para complementarlos con datos propietarios.
Index data
La búsqueda solo puede encontrar la información que previamente se ha indexado. Antes de que el RAG pueda responder preguntas, necesita una indexing pipeline que prepare los datos
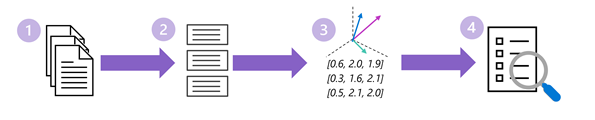
- Select source data
- Hacer chunking
- Hacer encoding de text tokens a embeddings
- Crear un index donde se puedan buscar estos embeddings
Select and process source data
Limpiar y procesar todos los documentos de entrada
- Cargar contenido de sus fuentes
- Extraer texto útil y estructurarlo
- Limpiar el contenido (remover headers repetidos, navigation text, etc )
- Añadir metadatos (título, source URL, categoría, etc)
Divide content into chunks
Los documentos por lo general son muy grandes para mandarselos completos a un modelo. Se dividen en pedazos más pequeños llamados chunks.
Cada chunk debe contener suficiente contexto para ser útil pero seguir manteniendose dentro del tema
El chunking es complicado
- Con chunks muy grandes tenemos información irrelevante y consume más de lo que debería la ventana de contexto
- Chunks muy pequeños y podemos separar una cabecera de su contenido u otra información relevante
Los chunks tienen algo de overlap entre ellos para que el contexto no se pierda en el límite
Create embeddings
Mediante un modelo de embeddings convertimos cada chunk de texto a un embeddings
Index data
La solución guarda los chunks, su embedding y metadatos útiles en un index de busqueda. Estos por lo general soportan:
- Keyword search: cuando buscamos palabras exactas
- Vector search: cuando buscamos contenido semánticamente similar
- Hybrid search: combina ambas
Retrieve information
Una vez tenemos el contenido indexado, el RAG se usa para responder a las preguntas del usuario
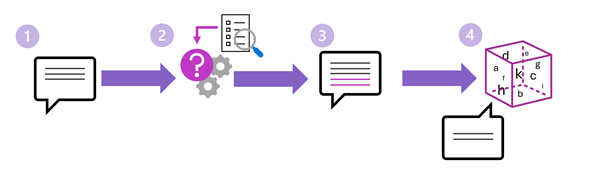
- El usuario envia un prompt
- Se hace una busqueda al index para obtener el contexto relevante
- El contexto se añade al prompt
- El augmented prompt se manda al LLM, el cual devuelve una grounded response
Access control es esencial. Los usuarios solo deberían de poder ver documentos a los que tienen permiso
Retrieve relevant information
La aplicacion prepara el input del usuario como una query de busqueda. Esta se encodea con el mismo embedding model que se ha usado en el proceso de indexado de documentos del RAG.
El objetivo del RAG es obtener el set de contenido más pequeño que provea de suficiente contexto para la respuesta, manteniéndose relevante
Augment the prompt
La aplicación construye el prompt de sistema y se inyecta el contexto obtenido mediante el RAG al prompt de usuario.
Generate a grounded response
El LLM usa el prompt aumentado para generar la respuesta. Una aplicación buena debería devolver también links o las citas en las que se basa la respuesta.
How to evaluate a RAG
Una vez hecho hay que evaluar que tal funciona el sistema
Evaluar contexto obtenido por el RAG
Podemos preguntarnos
- Relevance: Los chunks obtenidos en la busqueda responden la pregunta
- Coverage: tenemos toda la informacion presente para una respuesta completa
- Ranking: Los resultados más relevantes se colocan delante de los más débiles
- Security and freshness: El contenido del contexto está autorizado para el usuario y se mantiene actualizado
Evaluar la generación
Como el modelo ha usado el contexto obtenido
- Groundedness: Todo lo que afirma el LLM tiene su fuente? o hace claims que son inventados
- Relevance: la respuesta responde a la pregunta hecha por el usuario
- Completeness: la respuesta contiene toda la información que es importante y relevante del contexto
- Citation quality: las cita apuntan a fuentes que soportan lo que el LLM afirma?
- Appropiate uncertainty: la aplicación evita adivinar algo cuando no hay suficiente contexto?