Pasando por un modelo de embedding podemos convertir texto en vectores. Estos vectores representan puntos en un espacio inter-dimensional, definido por coordenadas en ejes.
Cada vector describe una dirección y una distancia desde el punto de origen. Pongamos el siguiente ejemplo:
| Word | Vector |
|---|---|
| dog | [0.8, 0.6, 0.1] |
| puppy | [0.9, 0.7, 0.4] |
| cat | [0.7, 0.5, 0.2] |
| kitten | [0.8, 0.6, 0.5] |
| young | [0.1, 0.1, 0.3] |
| ball | [0.3, 0.9, 0.1] |
| tree | [0.2, 0.1, 0.9] |
Podemos visualizar estos vectores en un espacio de 3 dimensiones:
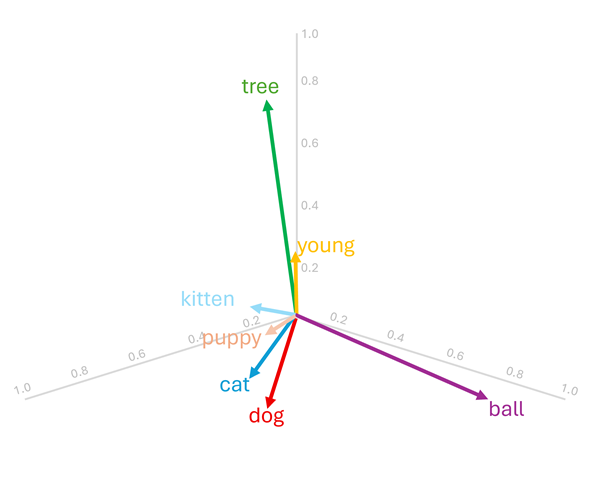
Podemos ver que los vectores de palabras semánticamente similares, son próximos unos a otros (dog, cat, puppy, kitten). Como las características intrínsecas de las palabras están encodeadas es las mismas, es posible ejecutar operaciones para comparar palabras y hacer análisis sobre ellas.
Encontrar términos relacionados
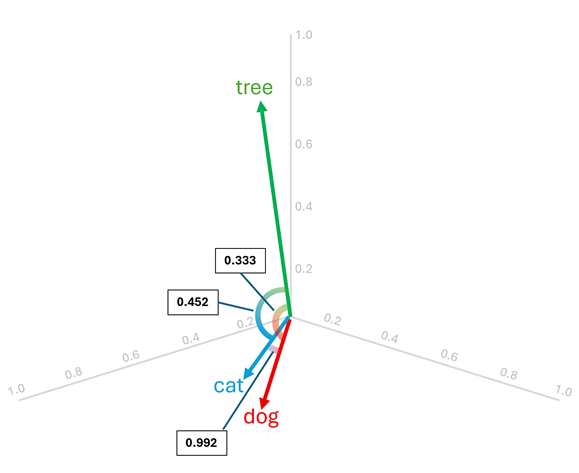
Como conocemos la dirección y la distancia de los vectores, y palabras similares tienden a tener orientaciones similares, podemos hacer cálculos como cosine similarity entre vectores, para hacer comparaciones.
En este caso podemos ver que la cosine similarity entre cat y dog (0.992) es mayor que con tree (0.333) y (0.452).
Vector translation (addition; substraction)
Como lo que tenemos es texto en forma de vectores, y estos vectores se pueden sumar y restar entre ellos, podemos aplicar operaciones básicas para transformar vectores.
En este ejemplo podemos ver que:
dog[0.8, 0.6, 0.1] +young[0.1, 0.1, 0.3] =puppy[0.9, 0.7, 0.4]cat[0.7, 0.5, 0.2] +young[0.1, 0.1, 0.3] = kitten [0.8, 0.6, 0.5]
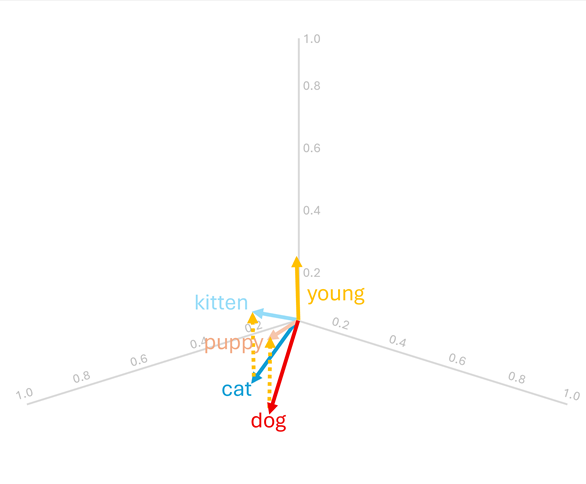
por lo general esto no produce resultados exactos, si no que hay que buscar el vector más próximo al resultado que hemos obtenido
podríamos hacer lo mismo con una resta (puppy - young = dog)
Razonamiento analógico
La aritmética de vectores puede responder preguntas como:
puppyes adog, lo quekittenes a?
Para resolver esto hacemos
kitten - puppy + dog = cat
Text analysis with semantic models
Así como hemos hecho estas operaciones, mediante análisis de texto podemos hacer:
Text summarization
Identificamos y extraemos los vectores más representativos del documento.
A cada frase se le da un vector y se calcula cuando son los más cercanos al significado del documento. Luego se extraen y se juntan estas frases para formar el summary.
Keyword extraction
vector similarity puede identificar los términos más importantes de un documento comparando los embeddings de las palabras con el vector del documento.
Named entity recognition
A los modelos semánticos se les puede hacer fine-tuning para reconocer named entities (people, organizations, locations, etc.) aprendiendo representaciones que agrupen entidades similares.
Text classification
Para tareas como sentimiento de análisis o categorización de tópicos, los documentos se pueden representar como vectores agregados (ej: el significado de todos los embeddings de un documento).
Estos vectores agregados se pueden pasar como input a algoritmos de ML o comparar con otros vectores agregados de otros documentos