How all works together
- Audio capture: captura la señal en raw
- Pre-processing: extraer MFCC features that highlight speech patterns
- Accoustic modeling: predict phoneme probabilities using transformer networks
- Language modeling: apply vocabulary and grammar knowledge
- Decoding: search for best word sequence
- Post-processing: format the text for human readers
Permite a las aplicaciones convertir idioma hablado en texto escrito.
Captura de audio: convertir audio análogo en digital
Se comienza convirtiendo las señales de audio en una señal digital. Se samplea el audio miles de veces por segundo - 16 kHz = 16,000 veces por segundo - y se guarda cada valor individual.
Ratios más altos (44 kHz para música) capturan más detalle pero requieren más procesamiento.
Para reconocimiento del habla se balancea entre 8 kHz y 16 kHz
En este paso se limpia la señal y se quita ruido de fondo.
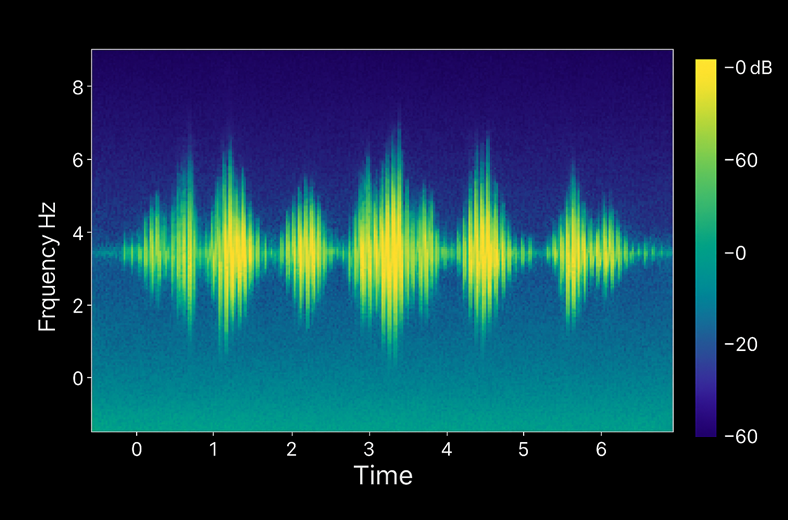
Pre-procesamiento: extraer meaningful features
El audio en crudo (raw) contiene demasiada información. Se hace un preprocesamiento para compactar la señal y retirar detalles irrelevantes
Mel-Frequency Cepstral Coefficients (MFCCs)
MFCC es la técnica más común para speech recognirition. Trabaja de forma parecida a como nuestros oídos escuchan el sonido - haciendo enfasis en las frecuencias donde se concentra la energia y comprimiendo las menos importantes
Como funciona MFCC:
- Divide el audio en frames: con un overlapping de 20-30 ms
- Aplica la transformada de Fourier: convierte cada frame de tiempo a frecuencia
- Mapea en la escala Mel: Ajusta frecuencias para adaptarlas al oído humano
- Extrae coeficientes: Computa un muestreo (13 coeficientes) que hace un resumen de forma espectral de cada frame
El resultado es una secuencia de vectores (uno por frame) que captura el sonido del audio sin tener que guardar cada sample.
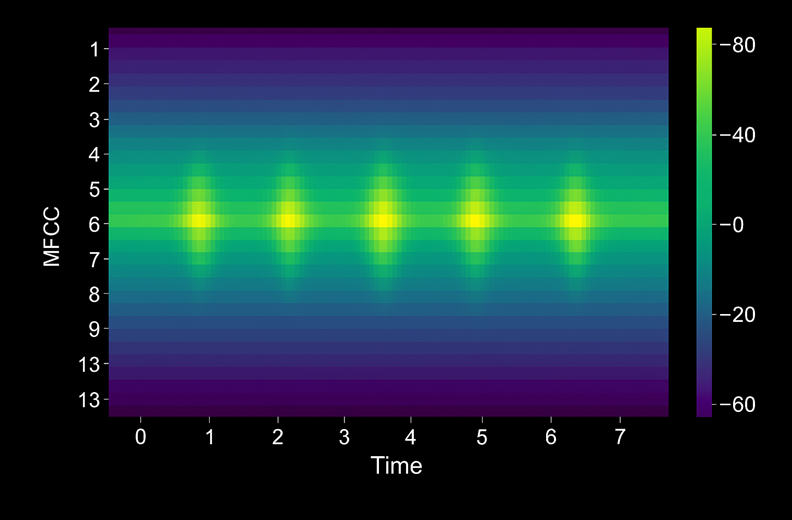
Estos vectores son el input para Acoustinc modeling
| Frame | Vector (13 coeficientes) |
|---|---|
| Frame 1 | [-113.2, 45.3, 12.1] |
| Frame 2 | [-112.8, 44.7, 11.8] |
| … | … |
Acoustic modeling: Recognize phonemes
Los modelos acústicos aprenden las relaciones entre audio features y fonemas.
From audio features to fonemas
Los modelos de audio actuales usan transformer architectures, un tipo de deep learning que se usa para procesar tareas en secuencia.
La transformer architecture procesa los vectores salidos de MFCC y predice que fonema es el más probable. Estos tienen en cuenta:
- Attention mechanism: el modelo examina los frames anteriores y siguientes para resolver ambigüedad (el fonema
/t/suena diferente al principio detopque al final debat) - Procesamiento paralelo: con los nuevos modelos, el transformer analiza multiples frames de forma simultánea
- Predicciones contextualizadas: la red aprende secuencias de fonemas que aparecen frecuentemente juntas en el lenguaje.
El output del modelo es una distribución de probabilidad de fonemas para cada frame de audio. (ejemplo: el frame 42 tiene un 80% de confidencia para /ae/, un 15% para /ɛ/ y un 5% para otros fonemas)
Los fonemas son específicos por idioma. Un modelo entrenado en inglés no se puede usar para Mandarin y viceversa
Language modeling: Predict word secuences
La predicción de fonemas no se puede usar por si sola ya que no garantiza una transcipción correcta. El modelo puede confundir their y there ya que comparten fonemas idénticos. Los modelos de lenguaje resuelven esta ambigüedad aplicando conocimientos de vocabulario, gramática y patrones de palabras.
- patrones estadísticos: El modelo entiende que
The weather is niceaparece más veces en sus datos de entrenamiento queThe wether is nice - context awareness: Después de
I need toel modelo sabe que es más probable un verbogoque un sustantivotable - domain adaptation: los modelos customizados se entrenan en (por ejemplo) terminología legal o médica para mejorar su porcentaje de aciertos
Decoding: Select the best text hypothesis
Los algoritmos de decoding buscan a través de millones de posible secuencias de palabras para encontrar las transcripciones que mejor encajan con ambos los modelos acústicos y los modelos de predicción.
Beam search decoding
La técnica más común, beam search, mantiene una shortlist (the “beam”) de las transcripciones parciales más probables al procesar cada frame de audio. En cada paso extiende las hipotesis con las palabras más probables y mantiene solo los mejores candidatos.
Decoding es computacionalmente MUY intensivo. Se restringe para mantener un equilibrio entre latencia y % de acierto
Post-processing: Refinar el output
El decoder produce raw text que hay que limpiar. Post-processing aplica reglas de formato y correcciones para mejorar la readability y la accuracy.
Post-processing common tasks
- Capitalización: convierte
hello my name is samaHello my name is Sam - añadir signos de puntuación: puntos, comas, etc.
- formateo de números: convierte
doscientos quincea215 - filtros de lenguaje: quitar palabras no apropiadas
- Inverse text normalization: convierte palabras como
three p ma3 PM - confidence scoring: marca resultados con una baja tasa de acierto para revisar (crítico en el campo médico)
Azure Speech devuelve la transcripción final junto a metadatos como tiempo o confidence score, permitiendo ajustar más fino con tu aplicación