Semantic model for images - Vision transformers
The same way we have transformers for embeddings to hold semantic meaning, we use vision transformer models, in which a model is trained using large volume of images. Instead of encoding text-based tokens, the transformer extracts patches of pixel values from the image, and generates a linear vector from the pixel values.
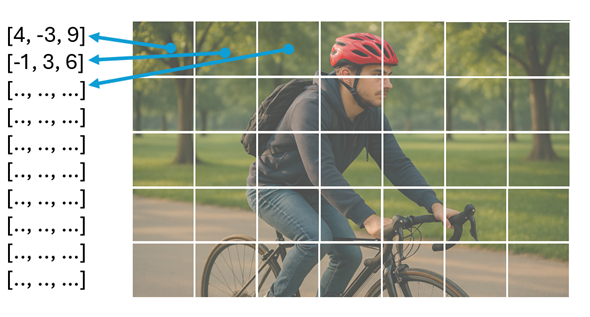
La misma técnica de attention que se usa en LLMs para los embeddings de relacionar contenido semántico, se usa aquí para relacionar los patches según diferentes características visuales como color, forma, contraste, textura, etc.
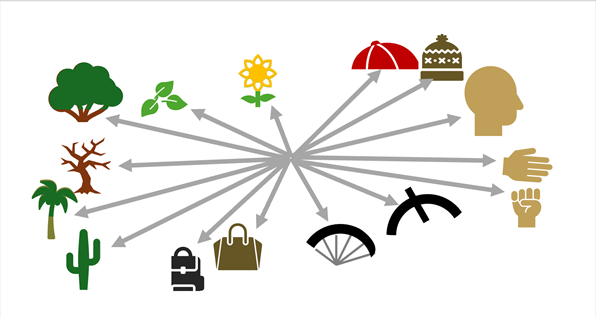
Los embeddings son embeddings, da igual si se crearon a partir de texto o de imágenes. Son vectores donde contenido relacionado tendrán direcciones similares.
Modelos multimodales
Un language transformer crea embeddings que hacen encoding de contenido semántico y relaciones entre palabras.
Un vision transformer crea vocabulario visual que hace lo mismo para imágenes.
Teniendo ambos encodings podemos juntarlos en un modelo multimodal, y usar una técnica llamada cross-model attention para conseguir una representación única y junta de todos los embeddings.
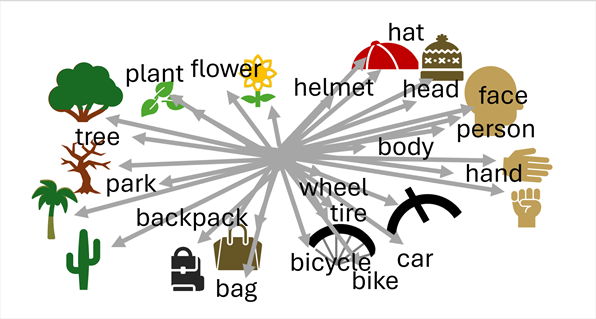
Image generation
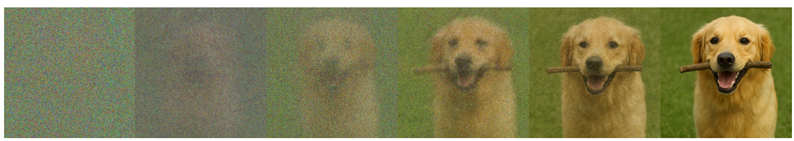
La mayoría de modelos de generación de imágenes usan una técnica llamada diffusion, la cual analiza el prompt de entrada e identifica las visual features que se necesitan combinar para crear esa imagen. La imagen se crea de manera iterativa comenzando con una imagen con ruido puro y quitando ruido paso a paso para crear estructura. Después de cada iteración, el modelo evalúa la imagen que tiene y la compara contra el prompt, hasta que se consigue una imagen final.
(ejemplo de creación con el prompt A dog carrying a stick in its mouth)