• Updated:
  • Featured post

How LLMs get their probabilities for the next token

(este post es una explicación de la teoría. dejo aquí otro post con el detalle práctico de como usar la temperature, top_k y top_p a efectos prácticos)

Explicación más en detalle de cómo obtienen los LLMs las probabilidades para generar el siguiente token

Sampling

En cada posición el modelo tiene una bolsa con miles de tokens posibles. Sampling es el proceso de no coger siempre el token más probable, si no de orientarlo a coger respuestas con determinadas características.

Si el modelo escogiera siempre el token con más probabilidades, obtendríamos respuestas aburridas y repetitivas.

Logits

Para generar el siguiente token, una red neuronal calcula primero los vectores de logits, donde cada logit corresponde a un valor posible. El tamaño de estos vectores de logits es tan grande como el vocabulario completo del modelo.

(representación de vectores de logits)

flowchart LR
	N1["What's your favorite color?"]:::note --> Z
	Z --> A1 --> A
	Z --> B1 --> B
	Z --> C1 --> C
	Z --> D1 --> D
	
	Z["Neural network"]
    A["a"]
    A1["(-0.5)"]
    B["green"]
    B1["(0.7)"]
    C["red"]
    C1["(0.5)"]
    D["the"]
    D1["(-1.2)"]
    
    classDef note fill:none,stroke:none,color:#777;    

Los logits NO representan probabilidades ya que no suman 1 y pueden incluso ser negativos (la probabilidades no pueden). Para convertir logits a probabilidades se usa una Softmax layer

Temperature

La temperatura es una constante que se aplica a los logits antes de la transformación de la Softmax layer. Se usa para ajustar la creatividad del modelo y redistribuir la probabilidad de los valores. Una temperatura más alta hace que el modelo sea más creativo ya que aumenta las posibilidades de elegir tokens menos probables.

xychart-beta
  title "Temperatura vs Probabilidad"
  x-axis "Temperatura (T)" [0.1, 0.2, 0.5, 1, 2, 5]
  y-axis "Probabilidad" 0 --> 1
  line "P(token1)" [0.9999546, 0.9933071, 0.8807971, 0.7310586, 0.6224593, 0.5498340]
  line "P(token2)" [0.0000454, 0.0066929, 0.1192029, 0.2689414, 0.3775407, 0.4501660]

Ejemplos de temperaturas:

  • Low (0.2-0.3): El modelo es cauto y elige las palabras más probables. Output factual y predecible.
  • Medium (0.5-0.7): Un mix de confiabilidad y engagement
  • High (0.9-1.0): Toma riesgos y es impredecible
Read More

How gen AI works under the hood

Los LLMs se entrenan para generar una respuesta en base a un prompt. Usan relaciones semánticas para entender las relaciones entre palabras (en lenguaje natural) y generar una respuesta relevante.

Teniendo el siguiente ejemplo, saben identificar las palabras más importantes y la posición contextual en la frase.

I heard a dog bark loudly at a cat

Tokenization

El primer paso es partir el input en tokens

  • I (1)
  • heard (2)
  • a (3)
  • dog (4)
  • bark (5)
  • loudly (6)
  • at (7)
  • a (3) already assigned
  • cat (8)

Vectores iniciales y encoding posicional

Inicialmente los vectores de los tokens se asignan de manera aleatorio, antes de ser alimentados al transformer para crear embeddings. Aparte de estos vectores aleatorios también se envía la posición del token en la secuencia, ya que es determinante para indicar su importancia.

recordar que los vectores aquí son aleatorios antes de que los procese el transformer

Token Token ID Position Vector
I 1 1 [3,7,10]
heard 2 2 [2,15,1]
a 3 3 [9,11,1]
dog 4 4 [2,7,11]
bark 5 5 [9,12,0]
loudly 6 6 [3,8,13]
at 7 7 [5,7,10]
a 3 8 [9,11,1]
cat 8 9 [8-6,9]

Transforming tokens with a transformer

Ahora que tenemos los tokens con un ID, necesitamos relacionarlos entre ellos. Esto se hace asignándoles vectores los cuales contienen el valor semántico del token (llamados embeddings)

[0.12, -0,85, …, 0.42]

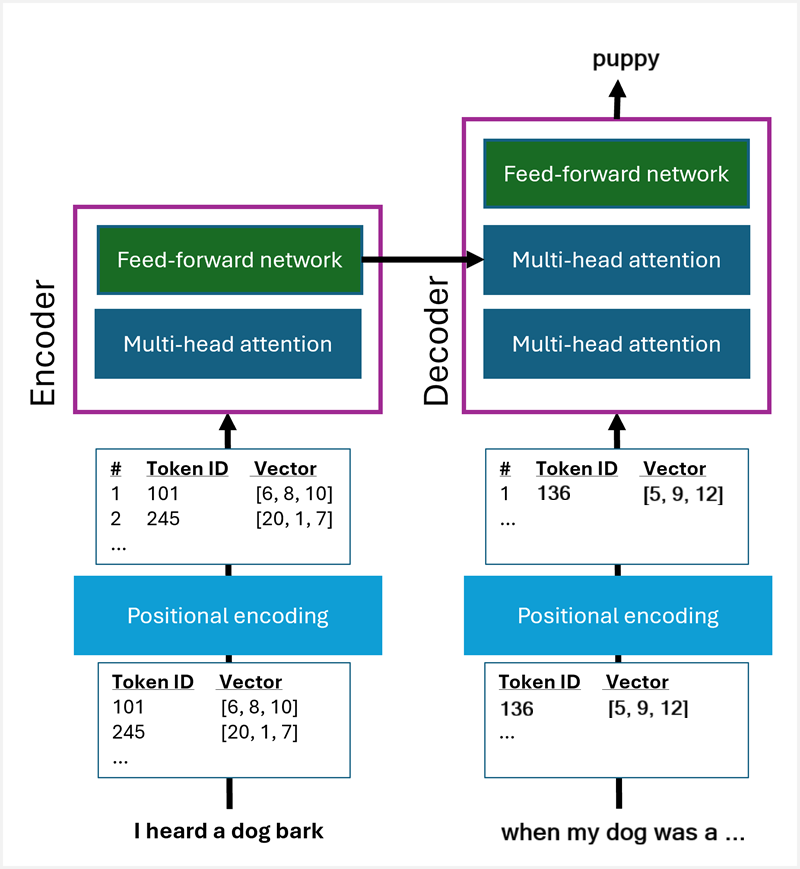
Esto se hace mediante un transformer model, el cual consiste de 2 bloques:

  • encoder block: crea los embeddings aplicando una técnica de attention. La attention layer examina cada token por turnos y determina cuánto se ve influenciado ese token por los que están a su alrededor. Para hacer este proceso de manera más eficiente se usa una multi-head attention para examinar tokens de manera paralela y asignarles weights que se usan para calcular los vectores. Los resultados de la attention layer se procesar por una red neuronal para encontrar los vectores que mejor representan al embedding.
  • decoder layer: usa los embeddings calculados por el encoder para determinar el próximo token más probable en una secuencia comenzada por un prompt. El decoder también consiste de una attention layer y una red neuronal para hacer sus predicciones

transformer block

Read More

  • Updated:

AI Base Concepts

Foundation Models

Los foundation models son modelos de IA generalistas entrenados con datasets diversos y masivos, que están listos para ser adaptados a muchos tipos de tareas diferentes.

Sobre todo NO están limitados a lenguaje escrito. Pueden trabajar con cualquier variación de: Texto, Imagen, Audio, Video y Código.

LLM (Large Language Model)

Los LLMs son sistemas estocásticos (no deterministas) entrenados para generar predicciones de texto basadas en prompts. Sus datos de entrenamiento se basan sobre todo en texto / código y se especializan en lectura / escritura y lenguaje oral. El truco está en que el modelo entienda la relación semántica entre palabras, y qué palabras de una secuencia son las que tienen más probabilidades de influir en la siguiente; el modelo usa esto para predecir cual es la siguiente palabra más probable en la secuencia.

Un LLM no tiene “memoria” como tal. Las conversaciones como tal no existen para ellos. Cada input de una conversación contiene todo lo que se ha hablado antes.

Al igual que tenemos LLMs, también existen SLMs (small language models). La diferencia se basa en el volumen de datos con el que han sido entrenados y en el número de variables, aunque no hay límites definidos.

Hay dos tipos de modelos de lenguaje (Aunque en principio un LLM se entrene para un tipo, esto se puede cambiar después mediante fine-tuning (ver infilling fine-tuning)):

  • Autoregressive: predice el siguiente token de una secuencia, usando los tokens previos como contexto. (My favorite color is _ )
  • Masked: fill-in-the-blank. Rellena un hueco usando como contexto los tokens que vienen antes y los de después (The _ is blue)

Agentes

Los agentes de IA son aplicaciones construidas sobre IA generativa que pueden razonar y generar mediante lenguaje natural, automatizar tareas usando herramientas y responder a condiciones contextuales para tomar las acciones apropiadas.

Se componen de:

  • Un LLM: es el cerebro del agente
  • Instrucciones: prompt de sistema que define el rol del agente y su comportamiento
  • Herramientas: las usa el agente para interactuar con su entorno. Se dividen en:
    • Knowledge tools: proveen de acceso a información (search engines, DDBB)
    • Action tools: permiten al agente ejecutar tareas (enviar emails, actualizar un calendario)

Ventana de contexto (Context Window)

La ventana de contexto es el limite de memoria que tiene un LLM. Determina cuánto de la conversación actual puede “mantener en memoria” el modelo.

Si la ventana es suficiente, el modelo podrá mantener la totalidad de la conversación en memoria, pero si nos pasamos del límite, el modelo comenzará a olvidarse de las primeras partes de la conversación, y comenzará a dar respuestas más vagas o alucinar.

Read More

AI-901: Microsoft Azure AI Fundamentals

(los posts aquí contenidos han sido creados (y contienen imágenes oficiales) siguiendo los cursos oficiales self-paced de learn.microsoft.com AI-901. Para más información recomiendo seguir los mismos cursos)

badge microsoft fundamentals AI-901

status: certified
Microsoft Certified: Azure AI Fundamentals

Contents

Identify AI Concepts and capabilities (40-45%)

  • Describe principles of responsible AI (fairness, reliability, privacy, transparency, accountability)
  • Identify AI model components and configurations
  • Identify AI workloads

Implement AI solutions by using Microsoft Foundry (55-60%)

  • Implement generative AI apps and agents by using Foundry
  • Implement AI solutions for text and speech
  • Implement AI solutions with computer vision and image generation
  • Implement AI solutions for information extraction

Microsoft official learning paths

AI concepts for developers and technology professionals

Microsoft responsible principles

AI

How gen AI works under the hood
Representar texto como vectores
RAG concepts
Prompts & agents

NLP

NLP concepts (techniques)

Information extraction

AI concepts extraction (OCR)

Speech concepts

Speech concepts
Speech recognition (speech-to-text)
Speech synthesis (text-to-speech)

Computer vision

Computer vision
Image processing
Vision transformers & Multimodal models

Get started with AI applications and agents on Azure Foundry

Azure

Understand Azure

AI in Microsoft Foundry

Microsoft Foundry for AI
genAI models in Foundry
Agents in Foundry

Microsoft Foundry by area

Text analysis in Foundry
Speech in Foundry
Computer vision in Foundry
Information extraction with AI (Azure Content Understanding)
Managed Knowledge Layer (Microsoft Foundry IQ)

Labs

Official labs (in python)

  • Updated:

Moq (It.isAny & mock multiple calls)

Mocking examples with Moq

It.IsAny<T> variables

Those are argument matchers we have in Moq for the case we don’t have the same instance match.

Exact instance match - most restrictive

Example for default comparison

[Theory, Autodata]
public async Task FilledString_Execute_CorrectlyProcessed(string name, AnimalDTO animal)
{
	// ARRANGE
	_dependencyMock
		.Setup(m => m.Load(name))
		.Returns(animal)
	
	// ACT
	AnimalDTO result = await _sut.Execute(name);
	
	// ASSERT
	_dependencyMock.Verify(m => m.Load(name));
}

It.IsAny<T> - most permissive

Matches any instance of that type, null included.

[Theory, Autodata]
public async Task FilledString_Execute_CorrectlyProcessed(string name, AnimalDTO animal)
{
	// ARRANGE
	_dependencyMock
		.Setup(m => m.Load(name))
		.Returns(animal)
	
	// ACT
	AnimalDTO result = await _sut.Execute(name);
	
	// ASSERT	
	// we use this in case the property is not accesible
	//   for example: a param created inside the class
	_dependencyMock.Verify(m => m.Load(It.IsAny<string>()));
}

Read More

  • Updated:

AI Data Grouding (RAG vs Fine Tuning)

TLDR:

  • RAG: complementar el prompt referenciando conocimiento concreto, actualizado o propietario
  • Fine-tuning: reentrenar el modelo para que cambie su estilo, tono o formato - altamente complejo. Sólo después de haber probado otros métodos.

El objetivo de customizar los modelos es mejorar aspectos de su performance, calidad y/o seguridad de sus respuestas.

Data Grounding

Proceso de enriquecer una respuesta generada por IA con datos externos o específicos para mejorar su calidad y/o seguridad de sus respuestas. Asegura que el output del modelo está alineado con datos factuales, contextuales y que son confiables.

Data Grounding es el objetivo, no una técnica.

Para responder al prompt la IA no se basará sólo y únicamente en los datos de su entrenamiento, si no que se le proporciona información adicional de una fuente externa (documentos, BBDD, APIs, etc.) para que sus respuestas estén basadas en datos reales y actualizados y no se los invente ni alucine.

RAG vs Fine-Tuning

¿Necesitas datos up-to-the-minute o acceso a datos privados? Por lo general se recomienda comenzar con RAG. Es más rápido de implementar y necesita menos datos que fine-tuning.

¿Necesitas que la IA hable/escriba en un estilo muy específico o que entienda un nicho de manera profunda? - Hacer fine-tuning. Ayuda al modelo a aprender patrones y estilos que solamente con RAG son muy difíciles de capturar.

¿Necesitas hacer tareas muy complejas que requieren datos específicos / actualizados y un conocimiento profundo? - Hacer ambos (Fine-tuning+RAG).

Read More

Fluent Assertions examples

Examples on how to test and assert exceptions with FluentAssertions.

with * it checks it contains the string. if you want exact matching, remove them

[Fact]
public async Task CreateAnimal_IsNull_ExceptionThrown()
{
	// ARRANGE 
	Animal? animal = null;
	
	// ACT 
	var act = async () => await sut.Create(animal);
	
	// ASSERT
	await act.Should().ThrowAsync<ArgumentNullException>()
		.WithMessage("*is null*");
}

AutoFixture (AutoData & AutoMoq)

AutoFixture is a .NET library to automatically generate test data. To use it install the following packages

AutoFixture
AutoFixture.Xunit2
AutoFixture.AutoMoq

Inyecting with AutoData

You can create the fixtures either manually or automatically. I do it automatically with [AutoData]

test class

public class AnimalControllerTests
{
	private readonly Mock<AnimalService> _serviceMock;
	private readonly AnimalController _sut;
	
	public AnimalControllerTests()
	{
		_serviceMock = new Mock<AnimalService>();
		_sut = new AnimalController(_serviceMock.Object);
	}
}

test method example

[Theory, AutoData]
public async Task Animal_Process_IsCorrectlyCreated(Animal animal, Guid guid)
{
	// when calling this test, Animal and Guid have already been inyected
	
	// ARRANGE
	_serviceMock.Setup(x => x.Create(animal))
		.Returns(guid);
	
	// ACT
	var resultGuid = await _sut.Process(animal);
	
	// ASSERT
	_serviceMock.Verify(m => m.Create(animal));
	resultGuid.Should().Be(guid);
}

Read More

XUnit tags and usage

Fact vs Theory

[Fact] son tests que se ejecutan siempre con los mismos valores fijos

[Fact]
public void Sum_TwoNumbers_ReturnsCorrectResult()
{
	// Act
	var result = 1 + 2;
	
	// Assert
	result.Should().Be(3);
}

[Theory] son tests parametrizados que se ejecutan múltiples veces con datos diferentes. Requieren de otro modificador que provea los valores

[Theory]
[InlineData(1, 2, 3)]
[InlineData(0, 0, 0)]
[InlineData(-1, 1, 0)]
public void Sum_TwoNumbers_ReturnsCorrectResult(int a, int b, int expected)
{
	// Act
	var result = a + b;
	
	// Assert
	result.Should().Be(expected);
}

Read More

  • Updated:

Testing. Code example for c# (NUnit)

(this project contains examples on how to use NUnit. Nowadays it’s better to use XUnit for new projects).

The following are code examples to test several scenarios.

(check this project to see more testing code examples)

General tests

This is a test to check an exception is thrown for a non-async method.

The method .WithMessage("*null payload*") works as a like. Any string that contains null payload will trigger as true.

[Test]
public async Task GivenNullPayload_WhenSetupPost_ThenAssertExceptionIsThrown
{
	// given
	string url = "http://somethingsomething.com"
	string nullPayload = null;
	
	// when
	Action result = () => _service.SetUpPost(url, nullPayload);
	
	// then
	result.Should().Throw<ArgumentNullException>().WithMessage("*null payload*");
}

This is the example for an async method.

[Test]
public async Task GivenNullPayload_WhenSetupPostAsync_ThenAssertExceptionIsThrown
{
	// given
	string url = "http://somethingsomething.com";
	string nullPayload = null;
	
	// when
	Func<Task> result = () => _service.SetUpPostAsync(url, nullPayload);
	
	// then
	await result.Should().ThrowAsync<InvalidOperationException>().WithMessage("*null payload*");
}

Read More