• Updated:
  • Featured post

How LLMs get their probabilities for the next token

(este post es una explicación de la teoría. dejo aquí otro post con el detalle práctico de como usar la temperature, top_k y top_p a efectos prácticos)

Explicación más en detalle de cómo obtienen los LLMs las probabilidades para generar el siguiente token

Sampling

En cada posición el modelo tiene una bolsa con miles de tokens posibles. Sampling es el proceso de no coger siempre el token más probable, si no de orientarlo a coger respuestas con determinadas características.

Si el modelo escogiera siempre el token con más probabilidades, obtendríamos respuestas aburridas y repetitivas.

Logits

Para generar el siguiente token, una red neuronal calcula primero los vectores de logits, donde cada logit corresponde a un valor posible. El tamaño de estos vectores de logits es tan grande como el vocabulario completo del modelo.

(representación de vectores de logits)

flowchart LR
	N1["What's your favorite color?"]:::note --> Z
	Z --> A1 --> A
	Z --> B1 --> B
	Z --> C1 --> C
	Z --> D1 --> D
	
	Z["Neural network"]
    A["a"]
    A1["(-0.5)"]
    B["green"]
    B1["(0.7)"]
    C["red"]
    C1["(0.5)"]
    D["the"]
    D1["(-1.2)"]
    
    classDef note fill:none,stroke:none,color:#777;    

Los logits NO representan probabilidades ya que no suman 1 y pueden incluso ser negativos (la probabilidades no pueden). Para convertir logits a probabilidades se usa una Softmax layer

Temperature

La temperatura es una constante que se aplica a los logits antes de la transformación de la Softmax layer. Se usa para ajustar la creatividad del modelo y redistribuir la probabilidad de los valores. Una temperatura más alta hace que el modelo sea más creativo ya que aumenta las posibilidades de elegir tokens menos probables.

xychart-beta
  title "Temperatura vs Probabilidad"
  x-axis "Temperatura (T)" [0.1, 0.2, 0.5, 1, 2, 5]
  y-axis "Probabilidad" 0 --> 1
  line "P(token1)" [0.9999546, 0.9933071, 0.8807971, 0.7310586, 0.6224593, 0.5498340]
  line "P(token2)" [0.0000454, 0.0066929, 0.1192029, 0.2689414, 0.3775407, 0.4501660]

Ejemplos de temperaturas:

  • Low (0.2-0.3): El modelo es cauto y elige las palabras más probables. Output factual y predecible.
  • Medium (0.5-0.7): Un mix de confiabilidad y engagement
  • High (0.9-1.0): Toma riesgos y es impredecible
Read More

RAG concepts

RAG (Retrieval Augmented Generation) es una técnica que complementa el prompt con información de diferentes fuentes de conocimiento externas, como documentos o emails, para aumentar el prompt con datos relevantes y basar la respuesta en esas fuentes.

La respuesta del modelo se basará en la información proveída (data grounding) y sirve para suplir carencias en los datos de entrenamiento de los modelos o para complementarlos con datos propietarios.

Index data

La búsqueda solo puede encontrar la información que previamente se ha indexado. Antes de que el RAG pueda responder preguntas, necesita una indexing pipeline que prepare los datos

RAG indexing

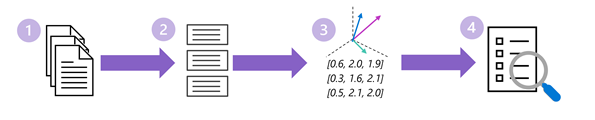
  1. Select source data
  2. Hacer chunking
  3. Hacer encoding de text tokens a embeddings
  4. Crear un index donde se puedan buscar estos embeddings

Select and process source data

Limpiar y procesar todos los documentos de entrada

  1. Cargar contenido de sus fuentes
  2. Extraer texto útil y estructurarlo
  3. Limpiar el contenido (remover headers repetidos, navigation text, etc )
  4. Añadir metadatos (título, source URL, categoría, etc)

Read More

AI concepts extraction

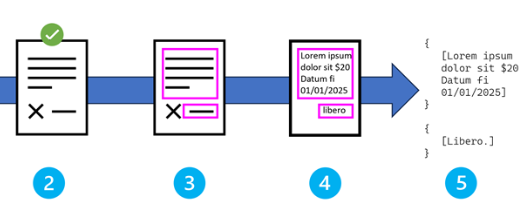
Esto se utiliza para extraer datos estructuradas desde media no estructurada como documentos, imágenes, audio o vídeo.

Optical Character Recognition (OCR)

Tecnología que convierte formatos visuales en texto.

OCR flow

  1. Preprocesamiento y mejoras de la imagen
  2. Detección de zonas de texto
  3. Character recognition and classification
  4. Output generation and post processing

Preprocesamiento e image enhancement

Antes de comenzar con la detección de texto se aplican técnicas para optimizar y mejorar la imagen

  • Noise reduction: remueve artefactos visuales, polvo o imperfecciones.
  • Contrast adjustment: mejora el contraste entre texto y fondo
  • Correción de desvíos (horizonte): alinea la rotación del documento
  • Resolution optimization

Text region detection

El sistema identifica las áreas que contienen texto usando las siguientes técnicas

  • Layout analysis: distingue entre zonas de texto, imágenes o gráficos y zonas en blanco
  • Text block identification: agrupa caracteres en palabras, lineas y parrafos
  • Reading order determination: de izq a derecha, top to bottom o viceversa
  • Region classification: identifica headers, body text, tables

Read More

Vision transformers & Multimodal models

Semantic model for images - Vision transformers

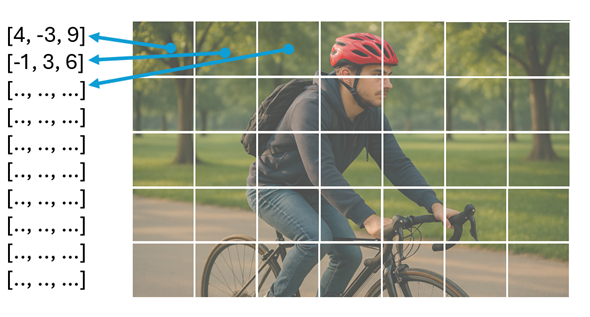
The same way we have transformers for embeddings to hold semantic meaning, we use vision transformer models, in which a model is trained using large volume of images. Instead of encoding text-based tokens, the transformer extracts patches of pixel values from the image, and generates a linear vector from the pixel values.

vision transformer

La misma técnica de attention que se usa en LLMs para los embeddings de relacionar contenido semántico, se usa aquí para relacionar los patches según diferentes características visuales como color, forma, contraste, textura, etc.

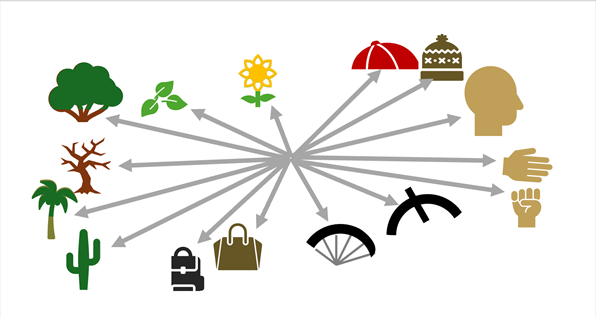
visual_embeddings

Los embeddings son embeddings, da igual si se crearon a partir de texto o de imágenes. Son vectores donde contenido relacionado tendrán direcciones similares.

Read More

Image processing

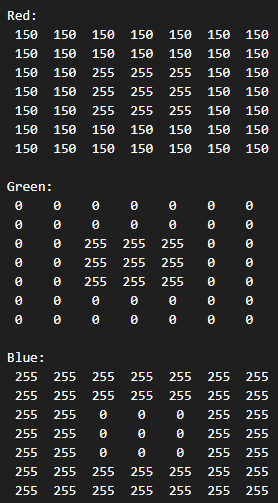
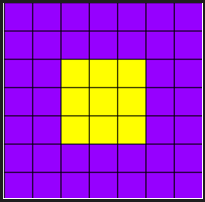
Para un ordenador una imagen es un array de pixel values.

(representación 7x7 de un cuadrado)

(pixel values)

image generation pixel values

(pixel representation)

image generation pixel representation

Filtros

Una manera de procesar una imagen es aplicar filtros que modifiquen los pixel values de esa imagen para crear un efecto visual. Un filtro se define por uno o más filter kernels (arrays de pixel values)

ejemplo de filter kernel 3x3

filter kernel

este filter kernel de 3x3 se irá ejecutando a lo largo de toda la imagen para obtener el resultado final

filter kernel processing

Si los valores se salen de la escala 0-255, estos se ajustan para que encajen de nuevo.

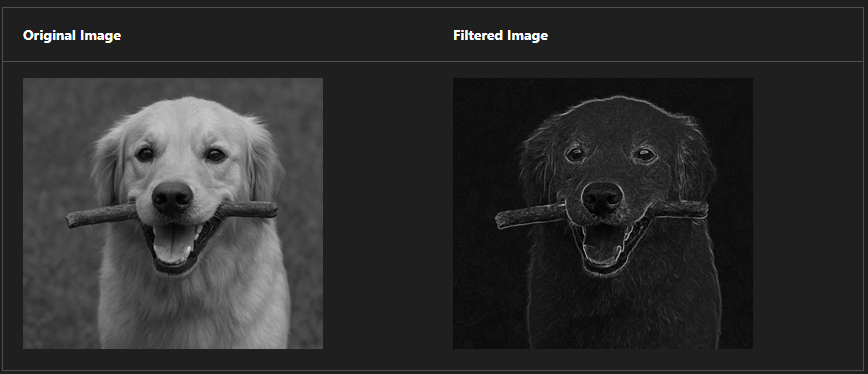
Este tipo de filtros se llaman convolutional filtering. Ejemplo de este tipo de filtros aplicado:

filter kernel result

Read More

Computer vision

Computer vision se centra en permitir a las aplicaciones de IA ser capaces de procesar información visual.

El término computer vision es una aglomeración de tareas y técnicas donde la IA procesa input visual, típicamente de imágenes, vídeos o live streams.

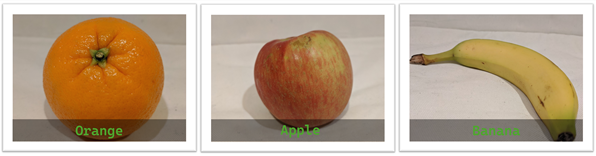
Clasificación de imágenes

Una de las ramas más antiguas. Un modelo es entrenado con un set de imágenes realmente grande para poder predecir una text label a partir de una imagen.

image classification example

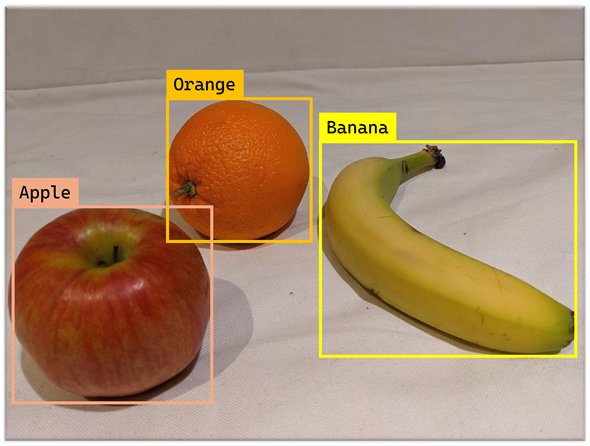
Detección de objetos

Examina multiples regiones de una imagen para encontrar objetos individuales y su posición en la imagen. Indica las coordenadas del objeto mediante un box rectangular.

object detection example

Segmentación semántica

Una técnica más sofisticada. Un modelo es estrenado para encontrar objetos y marcar sus píxeles individuales en la imagen.

semantic segmentation example

Read More

Speech synthesis (text-to-speech)

Pipeline de generación de audio

Cuando pides que se sintetice la siguiente frase

Dr. Chen’s appointment is at 3:00 PM

  1. Text normalization: lo convierte a Doctor Chen’s appointment is at three o’clock P M
  2. Análisis linguístico: lo convierte a fonemas /ˈdɑktər ˈtʃɛnz əˈpɔɪntmənt ɪz æt θri əˈklɑk pi ɛm/
  3. Generación de prosodia: detecta que hace falta subir un poco el tono para hacer énfasis en appointment, una pausa después de is y hacer enfasis de nuevo en three
  4. Speech synthesis: genera las ondas de audio para esas especificaciones

Normalización de texto

Preparar el texto para ser leido incluyendo números, símbolos etc

Dr. Smith ordered 3 items for $25.5

lo convierte a

Doctor Smith ordered three items for twenty-five dollars and fifty cents

Análisis linguístico: de texto a fonemas

  1. convertimos de segmentos de texto a sílabas y palabras
  2. mirar la pronunciación en lexicons (pronunciation dictionaries)
  3. aplicar reglas G2P o neural models a palabras no reconocidas
  4. marcar silabas e identificar las tónicas
  5. determinar contexto fonético

Read More

Speech recognition (speech-to-text)

How all works together

  1. Audio capture: captura la señal en raw
  2. Pre-processing: extraer MFCC features that highlight speech patterns
  3. Accoustic modeling: predict phoneme probabilities using transformer networks
  4. Language modeling: apply vocabulary and grammar knowledge
  5. Decoding: search for best word sequence
  6. Post-processing: format the text for human readers

Permite a las aplicaciones convertir idioma hablado en texto escrito.

Captura de audio: convertir audio análogo en digital

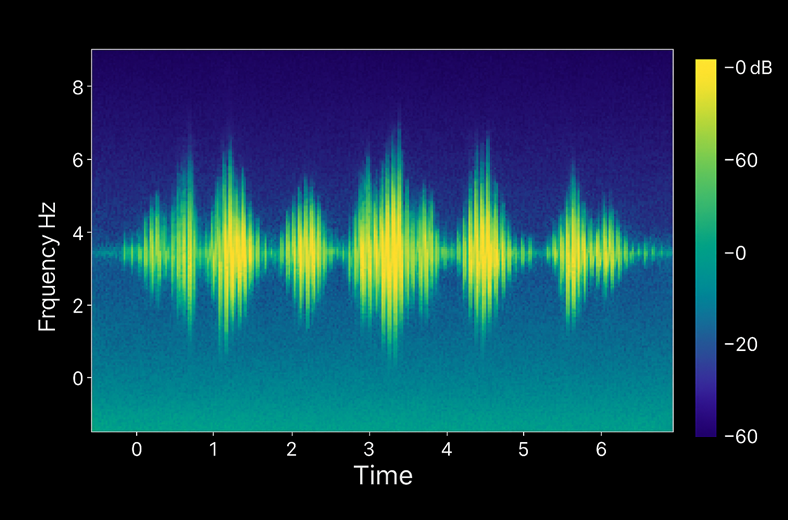
Se comienza convirtiendo las señales de audio en una señal digital. Se samplea el audio miles de veces por segundo - 16 kHz = 16,000 veces por segundo - y se guarda cada valor individual.

Ratios más altos (44 kHz para música) capturan más detalle pero requieren más procesamiento.

Para reconocimiento del habla se balancea entre 8 kHz y 16 kHz

En este paso se limpia la señal y se quita ruido de fondo.

speech recognition raw

Pre-procesamiento: extraer meaningful features

El audio en crudo (raw) contiene demasiada información. Se hace un preprocesamiento para compactar la señal y retirar detalles irrelevantes

Mel-Frequency Cepstral Coefficients (MFCCs)

MFCC es la técnica más común para speech recognirition. Trabaja de forma parecida a como nuestros oídos escuchan el sonido - haciendo enfasis en las frecuencias donde se concentra la energia y comprimiendo las menos importantes

Como funciona MFCC:

  1. Divide el audio en frames: con un overlapping de 20-30 ms
  2. Aplica la transformada de Fourier: convierte cada frame de tiempo a frecuencia
  3. Mapea en la escala Mel: Ajusta frecuencias para adaptarlas al oído humano
  4. Extrae coeficientes: Computa un muestreo (13 coeficientes) que hace un resumen de forma espectral de cada frame

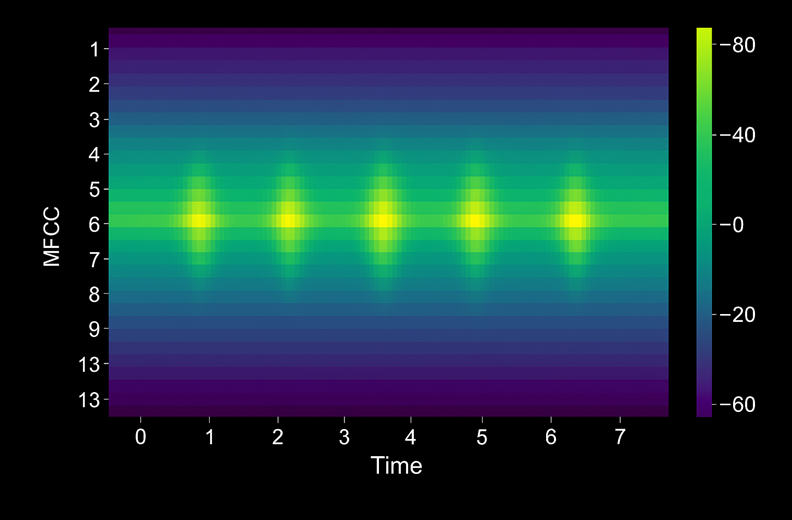
El resultado es una secuencia de vectores (uno por frame) que captura el sonido del audio sin tener que guardar cada sample.

speech recognition MFCC

Estos vectores son el input para Acoustinc modeling

Frame Vector (13 coeficientes)
Frame 1 [-113.2, 45.3, 12.1]
Frame 2 [-112.8, 44.7, 11.8]
… …

Read More

AI Speech concepts

Speech recognition convierte palabras habladas en texto, mientras que speech synthesis convierte texto en audio. Juntas permiten operar como manos-libres y mejoran la accesibilidad.

Speech-enabled solutions

Esto te puede ayudar a:

  • Accesibility: ayuda a usuarios con problemas visuales.
  • Productivity: permitir multitasking al quitar teclados y pantallas.
  • Mejorar UX al crear conversaciones naturales.
  • Audiencias globales al soportar multiples idiomas.

Speech-synthesis scenarios (text-to-speech)

Algunos ejemplos de casos de uso:

  • IA y chatbots conversacionales
  • Accesibilidad

Combine speech recognition and synthesis

Ejemplos:

  • Customer service: entender y responder al usuario
  • Aprendizaje de idiomas

Factores a tener en cuenta

  • calidad de audio: background noise, micro and network quality
  • idiomas soportados
  • privacidad: entender como se procesa y se guarda el audio
  • latencia: poder hablar y reconocer audio requiere low-latency
  • accesibilidad

Represent text as vectors

Pasando por un modelo de embedding podemos convertir texto en vectores. Estos vectores representan puntos en un espacio inter-dimensional, definido por coordenadas en ejes.

Cada vector describe una dirección y una distancia desde el punto de origen. Pongamos el siguiente ejemplo:

Word Vector
dog [0.8, 0.6, 0.1]
puppy [0.9, 0.7, 0.4]
cat [0.7, 0.5, 0.2]
kitten [0.8, 0.6, 0.5]
young [0.1, 0.1, 0.3]
ball [0.3, 0.9, 0.1]
tree [0.2, 0.1, 0.9]

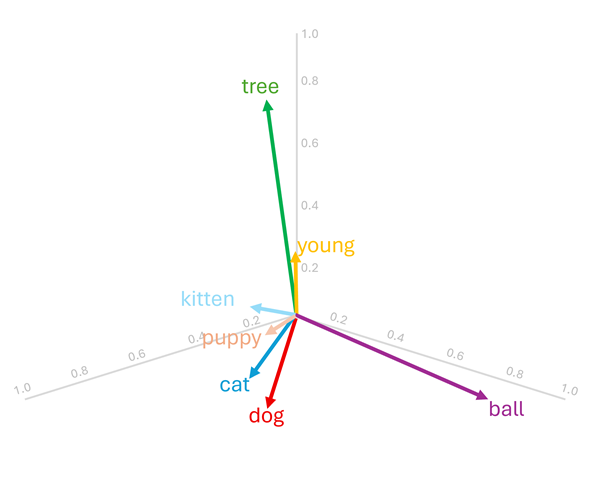
Podemos visualizar estos vectores en un espacio de 3 dimensiones:

vectores 1

Podemos ver que los vectores de palabras semánticamente similares, son próximos unos a otros (dog, cat, puppy, kitten). Como las características intrínsecas de las palabras están encodeadas es las mismas, es posible ejecutar operaciones para comparar palabras y hacer análisis sobre ellas.

Encontrar términos relacionados

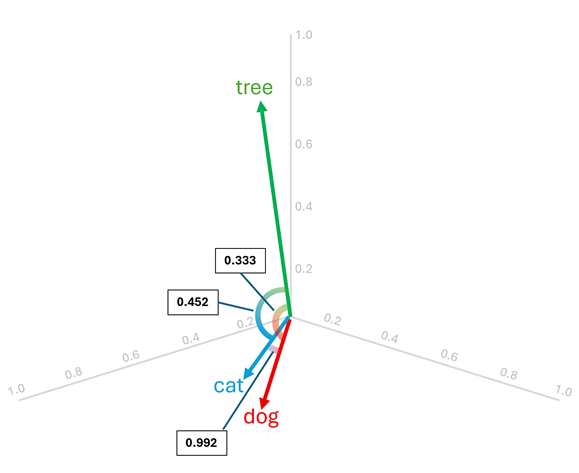
Como conocemos la dirección y la distancia de los vectores, y palabras similares tienden a tener orientaciones similares, podemos hacer cálculos como cosine similarity entre vectores, para hacer comparaciones.

En este caso podemos ver que la cosine similarity entre cat y dog (0.992) es mayor que con tree (0.333) y (0.452).

vectores cosine similarity

Vector translation (addition; substraction)

Como lo que tenemos es texto en forma de vectores, y estos vectores se pueden sumar y restar entre ellos, podemos aplicar operaciones básicas para transformar vectores.

En este ejemplo podemos ver que:

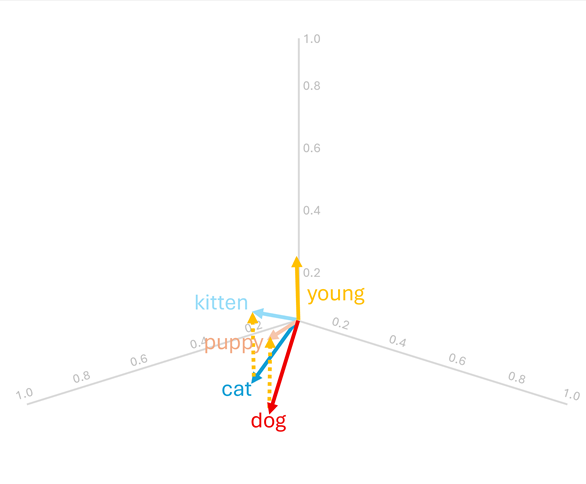
  • dog [0.8, 0.6, 0.1] + young [0.1, 0.1, 0.3] = puppy [0.9, 0.7, 0.4]
  • cat [0.7, 0.5, 0.2] + young [0.1, 0.1, 0.3] = kitten [0.8, 0.6, 0.5]

vectores translation

por lo general esto no produce resultados exactos, si no que hay que buscar el vector más próximo al resultado que hemos obtenido

podríamos hacer lo mismo con una resta (puppy - young = dog)

Razonamiento analógico

La aritmética de vectores puede responder preguntas como:

puppy es a dog, lo que kitten es a ?

Para resolver esto hacemos

kitten - puppy + dog = cat

Read More

NLP concepts

NLP es Natural Language Processing
NLU es Natural Language Understanding

Partimos de la base que tenemos un texto ya partido en tokens

  • We
  • choose
  • to
  • go
  • to
  • the
  • moon

    Técnicas Pre-procesamiento

Antes de hacer ningún tipo de procesamiento de lenguaje, pre-procesamos los tokens en función de lo que queramos conseguir

Técnica Descripción
Text normalization Antes de generar el token podemos querer normalizar el texto en función de nuestro análisis (quitar signos puntuación, todo a minúsculas). Esto puede ayudar para análisis de frecuencia de palabras pero perdemos significado semántico.

Mr Banks has worked in many banks. quizás queramos diferenciar entre la persona y el banco, o entre banks. y banks. Ese punto añade información de que la frase termina
Stop word removal Stop words son palabras que se deben excluir del análisis ya que no aportan nada. Por ejemplo the, a, it
N-gram extraction Encontrar frases que se puedan representar de diferentes maneras: artificial intelligence o natural language processing.
Una frase con una palabra es un unigram, con dos palabras es bigram, con tres trigram
Stemming Técnica para consolidar palabras quedándote solo con la raíz: si de las siguientes palabras powering, powered, powerful quitamos las terminaciones ing, ed, ful nos queda el mismo token power
Lemmatization Otra forma de reducir palabras a su forma base (llamada lemma). A diferencia de stemming no acorta las palabras si no que se basa en linguistica y vocabulario para asegurarse que el resultado es válido. Ejemplo running -> run o global -> globe
Parts of speech (POS) tagging Poner labels a cada token con su categoría gramatical (noun, verb, adjective or adverb). Tiene en cuenta el token y su contexto en la frase

Statistical text analisis

Una vez tenemos ya hecho el pre-procesamiento y los tokens, podemos hacer análisis sobre documentos

Frequency Analysis

La forma más obvia en analizar un único documento aislado. Consiste en contar el número de veces que aparece un token en un documento.

Term Frequency
ai 4
business 3
benefit 2

Read More